Das Thema ist schon sehr lange auf meiner Liste und um ehrlich zu sagen, habe ich das auch schon mit einem HA-DEV diskutiert. Das Problem an der Stelle ist das man (ich rede nur von der SFML DB) 3 Dinge unterscheiden muss:
Recorder-Daten und Backfill Mechanismen → Das ist eine bewusste Architektur-Entscheidung! Viele nutzen Cloud-Dienste (Anker, Fronius, Ecoflow,..) und haben keinen lokalen API-Zugriff. Das führt dazu, das die Intervalle wann Daten bereitgestellt werden sehr sehr unterschiedlich sind. Home Assistant bildet Riemann-Werte zur vollen Stunde. Nun ist es einfach zu verstehen, wenn eine Cloud nicht zur vollen Stunde sondern z.B. 5 Minuten später die Daten liefert, was das für den Riemann und die Datenqualität bedeutet. Um das abzufangen habe ich den sog. Backfill eingebaut.
Direkte Berechnungen → Mein Code versucht in einigen Bereichen (überall wo es geht) direkt selbst zu rechnen, um den unter Punkt 1 genannten Problem zu begegnen. Das gilt insbesondere bei Power-Sensoren, Smart-Metern,..
Persistente Datenspeicherung → Um nicht jeden Mal nach einem Neustart erst wieder neu berechnen / abfragen zu müssen, speichert mein Code Snapshots. Auch ist SFML generell sehr defensiv ausgerichtet und stellt sich hinten an um nicht andere Integrationen / Prozesse zu laggen.
Ich denke es ist leicht zu erkennen, wohin das führt wenn an einer Stelle durch menschliches Eingreifen ein Wert verändert wird. Absolutes Chaos und zerstörte Commits in den DB. → Daher sage ich auch immer wieder " Bitte manipuliert nicht die DB". Sie muss zwingend synchron mit der von euch verwendeten Cloud, HA-DB. .. sein. Besonders kritisch ist hier Anker. Die Anker-Cloud hat variable Push-Routinen (auch fronius) und sendet oft Chunks über eine Zeitraum (Letter Push bis aktueller Push). Das fange ich im EOD ab.
Gibt es keine Lösung? - JaEin aktuell prüfe ich mit sogenannten Schatten Datenbanken oder auch Hilfsdatenbanken zu arbeiten. Das technische Prinzip dahinter ist, dass die original Datenbank nicht angefasst wird, aber einen Flag erhält der bei Änderungen zu einer 2 Datenbank (korrigierte Werte) führt. Prinzipiell ist das ein normaler Vorgehen, ABER kostet beim Boot von HA zusätzliche Rechenleistung. Da sind wir dann wieder beim Thema " Ha nutzt nur einen Single-Thread" und meine bisherigen Versuche sind in einem Blocking-Call oder ausgebremsten System gelandet.
Aktuell teste ich noch, meine Idee: Nur bestimmte Werte “korrigierbar” machen, so das die Last auf der Shadow-DB nicht zu groß wird. Ein Mittelmaß habe ich aber noch nicht gefunden.
Generell zum Thema SFML DB: Die Architektur hat einen automatischen Purge, das bedeutet das die DB eine maximale Größe von 200MB - 300MB in einem Jahr nicht überschreiten sollte. Interne Test liegen sogar weiter darunter (80 - 110MB) → um sie weiter zu verschlanken und kleiner zu halten habe ich die KI-Learning Steps geändert und arbeite aktuell mit einem Promotion-Gate. Ich Speicher also nur noch die Besten trainierten Modelle und nicht mehr jedes. Das ist es auch was den EOD auf unter 30 Sek drückt.
Bevor nun jemand mit WAL kommt.. nein das geht nicht! Besonders dann nicht wenn jemand seinen HA via SMB anbindet. Ich habe den Writer und reader extra zentralisiert und PAGMA ist mein Mittel der Wahl mit klaren Verträgen und Commits.. und Retry-Logik und Time-Outs im Executer!
Fazit:
Es ist komplexer als man zunächst meint! - Aber ich suche nach einer Lösung die für alle sicher funktioniert. - Ich denke damit ist nur klarer warum es noch dauern wird bis ich eine stabile Lösung präsentieren kann. Weiteres Nachfragen hilft hier nicht weiter, da es kein Zeit sondern ein technisches Thema ist.
HA DB bereinigen:
Hier rate ich zur äußersten Vorsicht und man sollte genau wissen was mach macht! - ob es überhaupt sinnvoll ist! - Besser ist via yaml Dinge auszucomitten von denen man 100% sicher ist, dass man sie nicht (niemals) benötigt.
Das ist eine generelle Frage, die ich tatsächlich nicht ausreichend mit einbezogen habe
Die Antwort ist in HA selbst, seiner Architektur. Grundsätzlich speichert Home Assistant alle Sensoren die irgendwo angelegt sind - egal welche Integration!
Hier muss man sich anschauen, welche Recorder-Werte brauche ich eigentlich wirklich. Alles was man nicht benötigt sollte man via Yaml ausklammern. Klassische Kandidaten sind Zustandsänderungen, Uhrzeiten, … aber immer mit dem nötigen Augenmaß! - Eine generelle Lösung gibt es nicht! Man muss auch daran denken, dass eine Neuinstallation immer wieder neue Meta-ID´s erzeugt und es durch aus sinnvoll sein kann, alte Meta-ID`s zu mergen.
Beispiel: vorher hieß eine Sensor: sensor.gesamterzeugung_solar nun heißt er sensor_gesamt_solar → da wäre es kontraproduktiv den " alten Sensor" zu löschen, wenn man eine lange Historie möchte. Alle Tools die so kenne machen diese Unterscheidung nicht und man verliert wichtige alte Daten. → dazu hatte ich mich auch schon einmal im Showroom geäußert. Selbst wenn man die Sensoren wieder den selben Namen gibt, ist nicht immer sicher das die Historischen Daten übernommen werden..
Ich hatte dazu schon einmal einen Thread eröffnet und ein Script vorgestellt, dass genau das macht: Daten von einem alten Sensor auf einen neuen Übertragen, so das Historien nicht verloren gehen und man gefahrlos die DB aufräumen kann. → auf Grund der Kommentare " Das braucht kein Mensch, ect ect.. und Unverständnis wie HA intern arbeitet und was Meta-ID´s sind, wie HA Daten ablegt und verarbeitet" habe ich das wieder eingestellt und nutze es nur für mich.. (ich habe lange versucht zu erklären warum das für eine Datenbankpflege wichtig ist und man so “sauber starten” kann, Datenbanken klein und schnell bleiben..) meine Erklärungen dazu waren eher wie Lancelot mit seinen Windmühlen..
Am Ende des Tages habe ich es dann still und heimlich in SFML eingebaut das ist der Grund warum die SFML DB so klein und effektiv bleibt - auch nach einer Neuinstallation von HA und Zurückkopieren der alten SFML DB.
Hinweis zum Ausklammern via YAML:
Wir hatten hier auch schon Fälle wo SFML den Dienst versagt hat, da Nutzer wichtige Sensoren von HA ausgeklammert hatten und der Backfill (wie im vorangegangenen Post erklärt) nicht funktioinert und riesige Datenlücken über den Tag entstanden sind. Besonders beliebte Kandidaten: Power-Sensore, Wettersensoren,..
Fazit: Mit gesundem Menschenverstand und äußerster Vorsicht die HA DB und generell Datenbanken manipulieren - und verstehen wie HA arbeitet.. es ist eine Datenbank Software und kein klassische " Betriebssystem" eher ein Hybrid ( das BS ist die Kernel-Ebene / Linux darunter)
Es gibt ein Update:
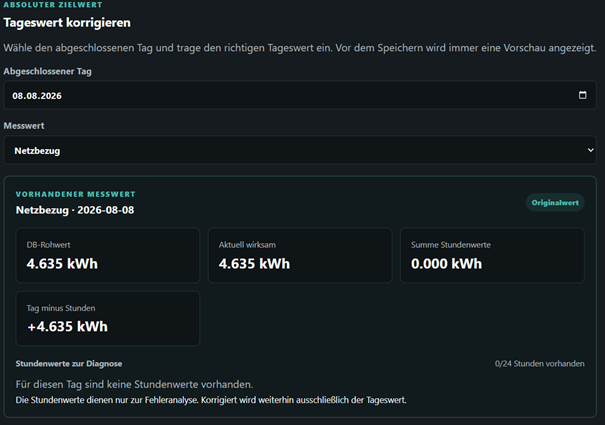
Mit den Hilfstabellen funktioniert es. Kommt im kommenden Update als Premium-Feature → zunächst einmal nur für die Strom-Sparte, wenn es sich im Alltag bewährt im nächsten Schritt auch für andere Sensoren / Werte!
Ein korrigierter Tageswert wird im Billing und Export identisch erscheinen, wird aber weder Lernen noch die laufende Erfassung rückwirkend beeinflussen.
Ich sehe es als “Ersten Versuch / Test” - das bitte im Hinterkopf behalten!
Wie bereits erklärt, ist das nicht wirklich einfach und eine sehr kritische Operation. Meine Integrationen basieren auf 100% Home Assistant ( und den von HA gepflegten Repros) - daher halte ich mich zu 100% an die Vorgaben - das bringt Einschränkungen mit sich, die wichtig und und richtig sind.
Ich würde Dich bitten es zu testen (kommt nach dem EOD heute).
Hausverbrauch – ergibt sich aus mehreren Energieflüssen
Solar → Haus, Solar → Akku, Netz → Haus, Netz → Akku
Akkuladung und Akkuentladung
Eigenverbrauch und Autarkie
Kosten, Ersparnis und Einspeiseerlös
Wirkungsgrade
Spitzenleistung und Uhrzeit
Forecast-, Wetter- und ML-Werte
Diese Werte hängen voneinander ab. Eine Einzelkorrektur könnte beispielsweise mehr Hausverbrauch als verfügbare Energie oder einen unmöglichen Akkuwirkungsgrad erzeugen. Die Gefahr ist zu groß, dass etwas bricht.
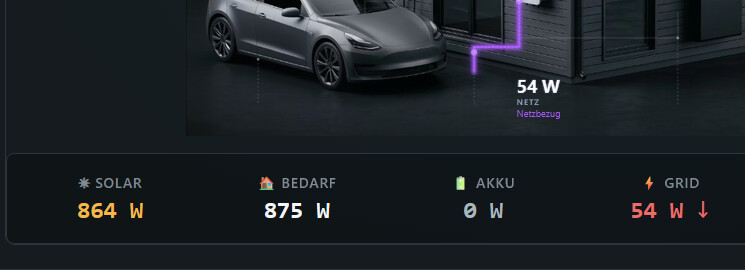
Macht es Sinn, bei den Überschriften AC und DC in Klammern zu erwähnen? Gerade für Neueinsteiger stelle ich mir das hilfreich vor.
Nicht jedem Neueinsteiger erschließt sich sofort, dass die angezeigten W bei Solar DC sind und die W bei GRID AC, zumal man bei den Apps zu den BKW-Wechselrichtern meistens nur den AC-Wert im Blick hat, denke ich.
Dieser Pfeil bei Strombezug ist eher ein persönliches Ding. Für mich sieht es optisch so aus, als ob ich Strom ans Netz abgebe, weil der Pfeil für mich gefühlt “raus” zeigt.
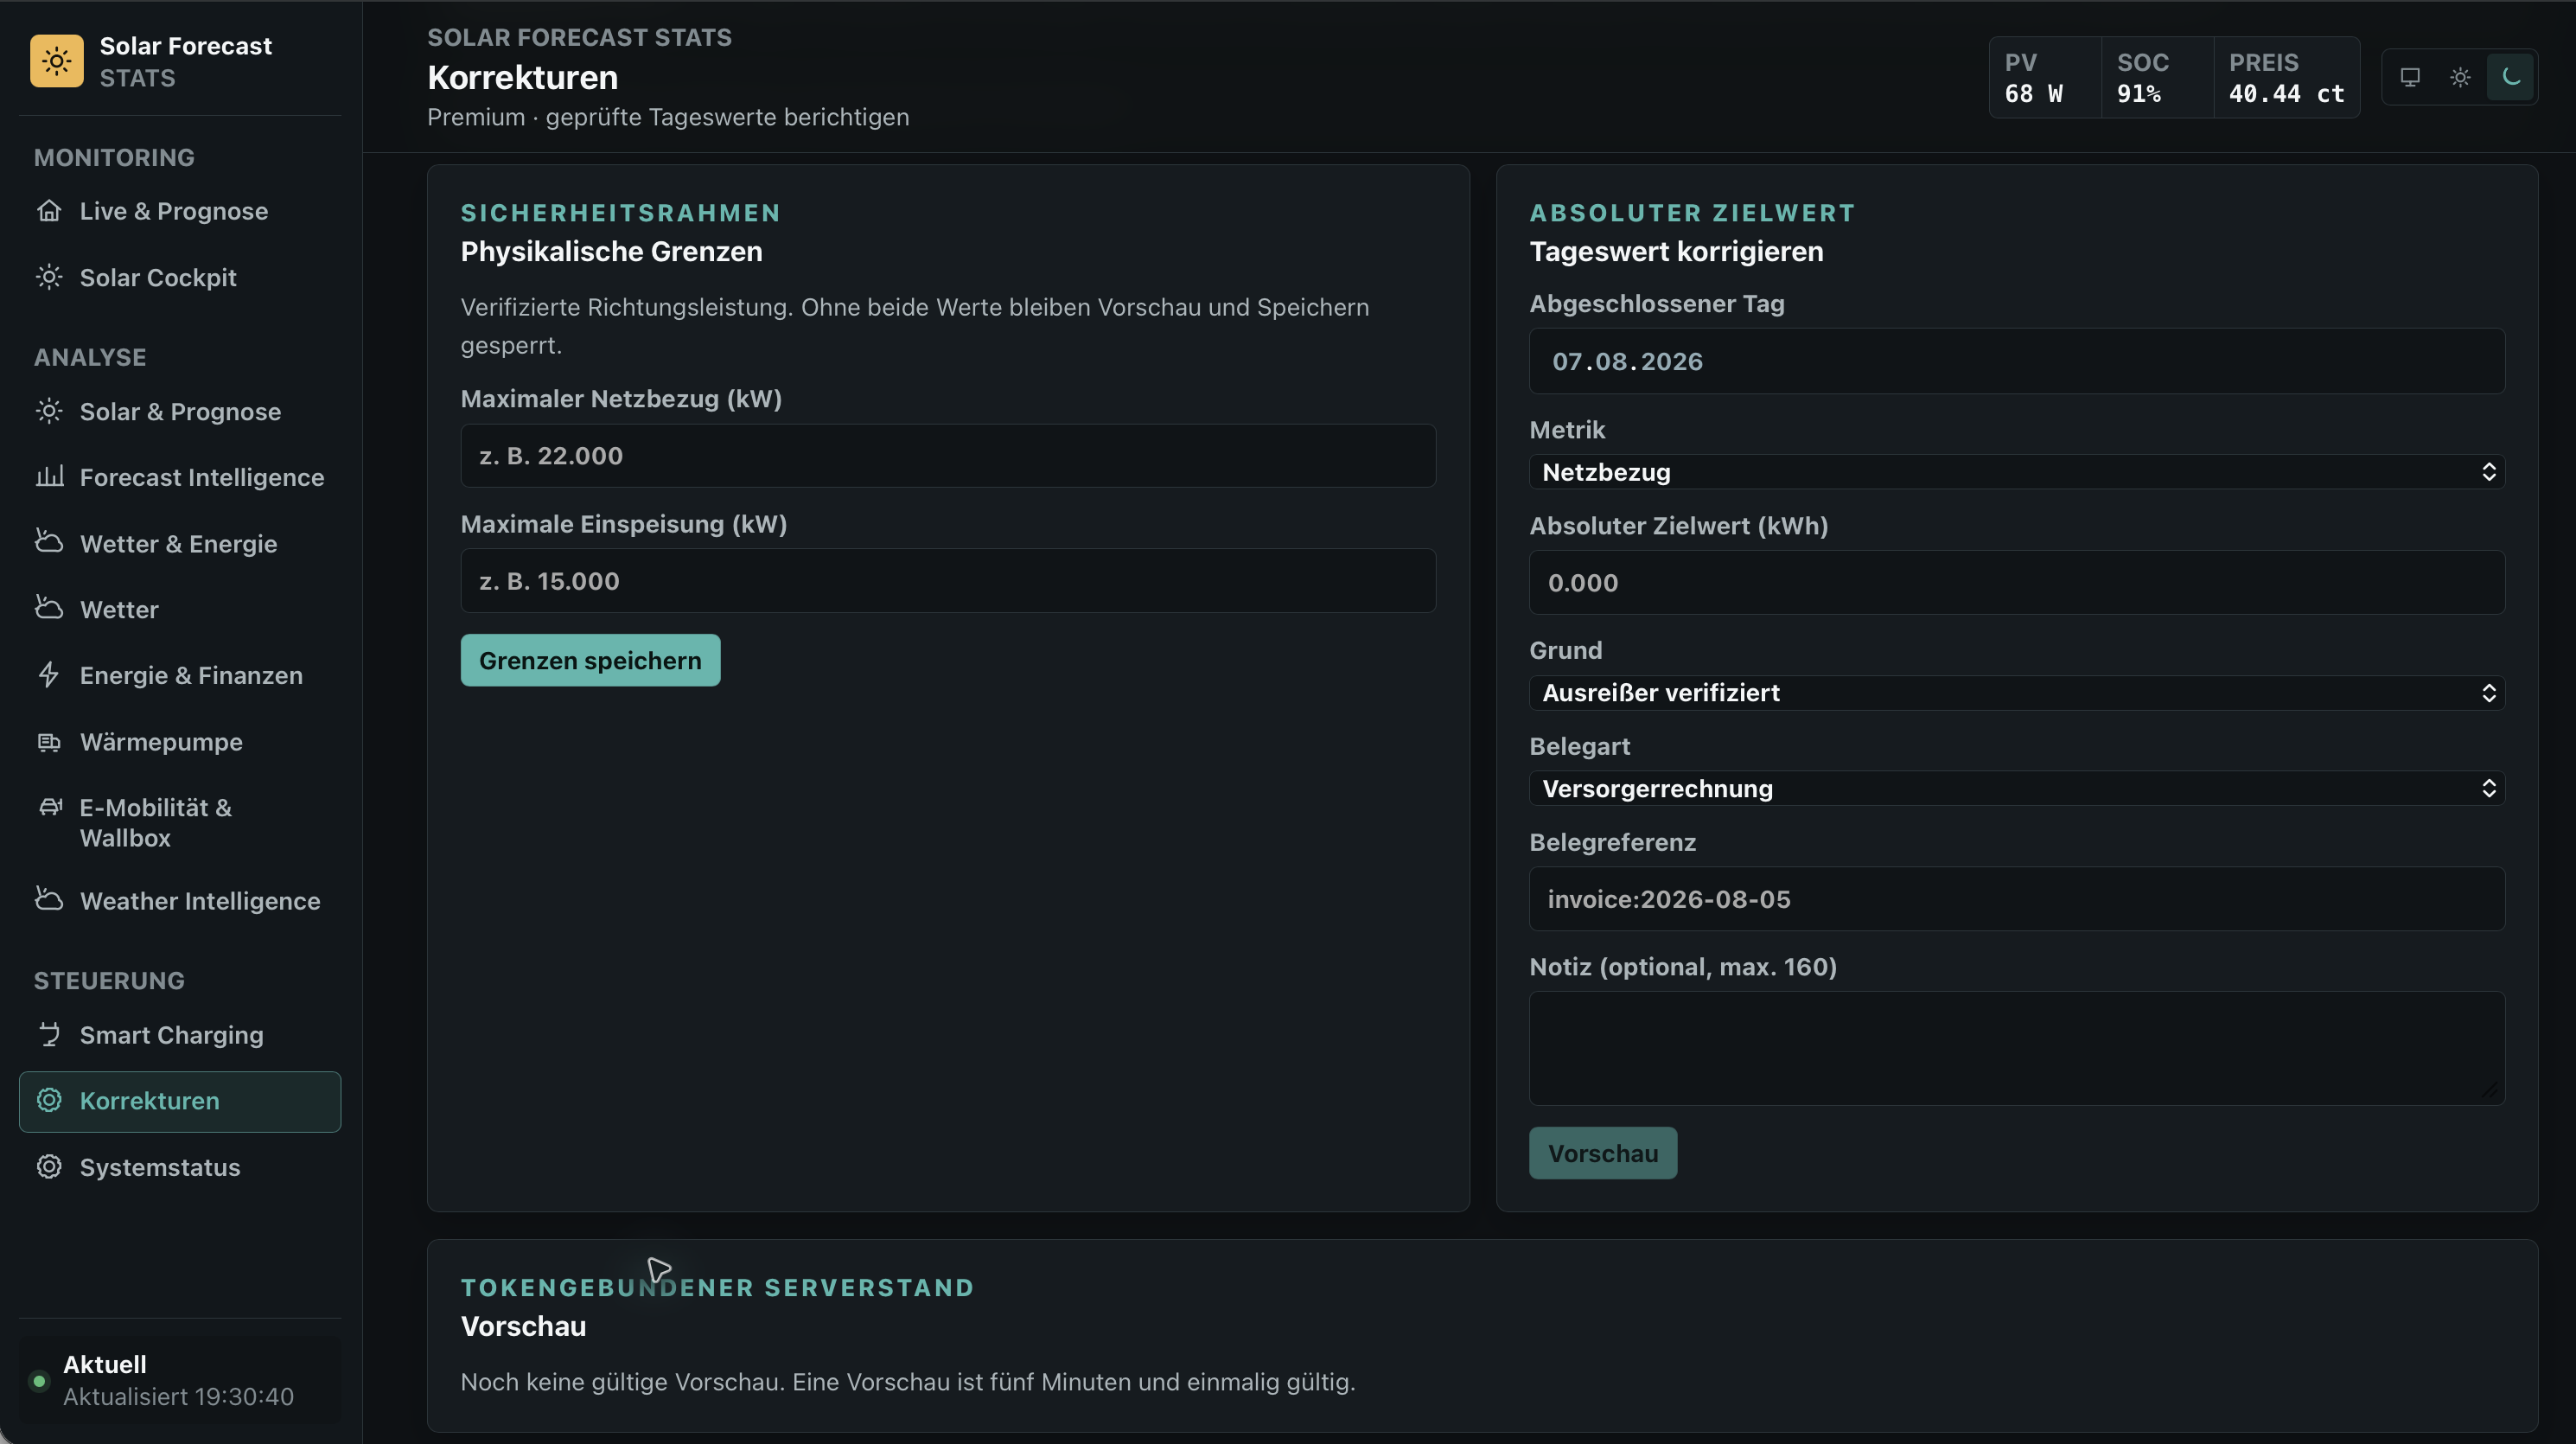
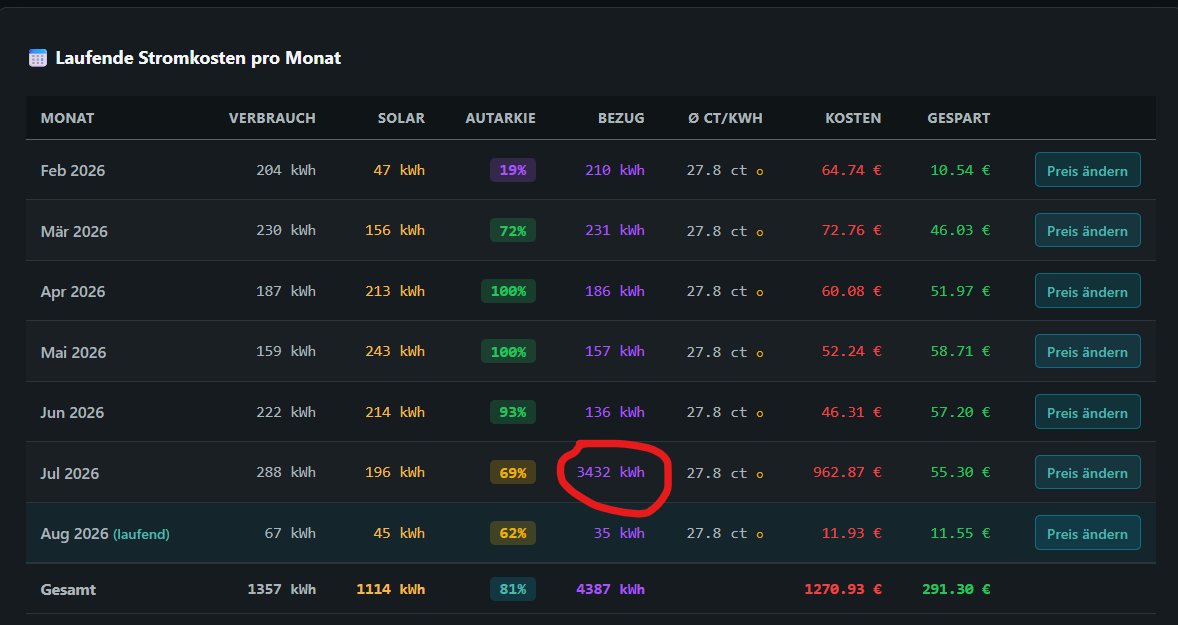
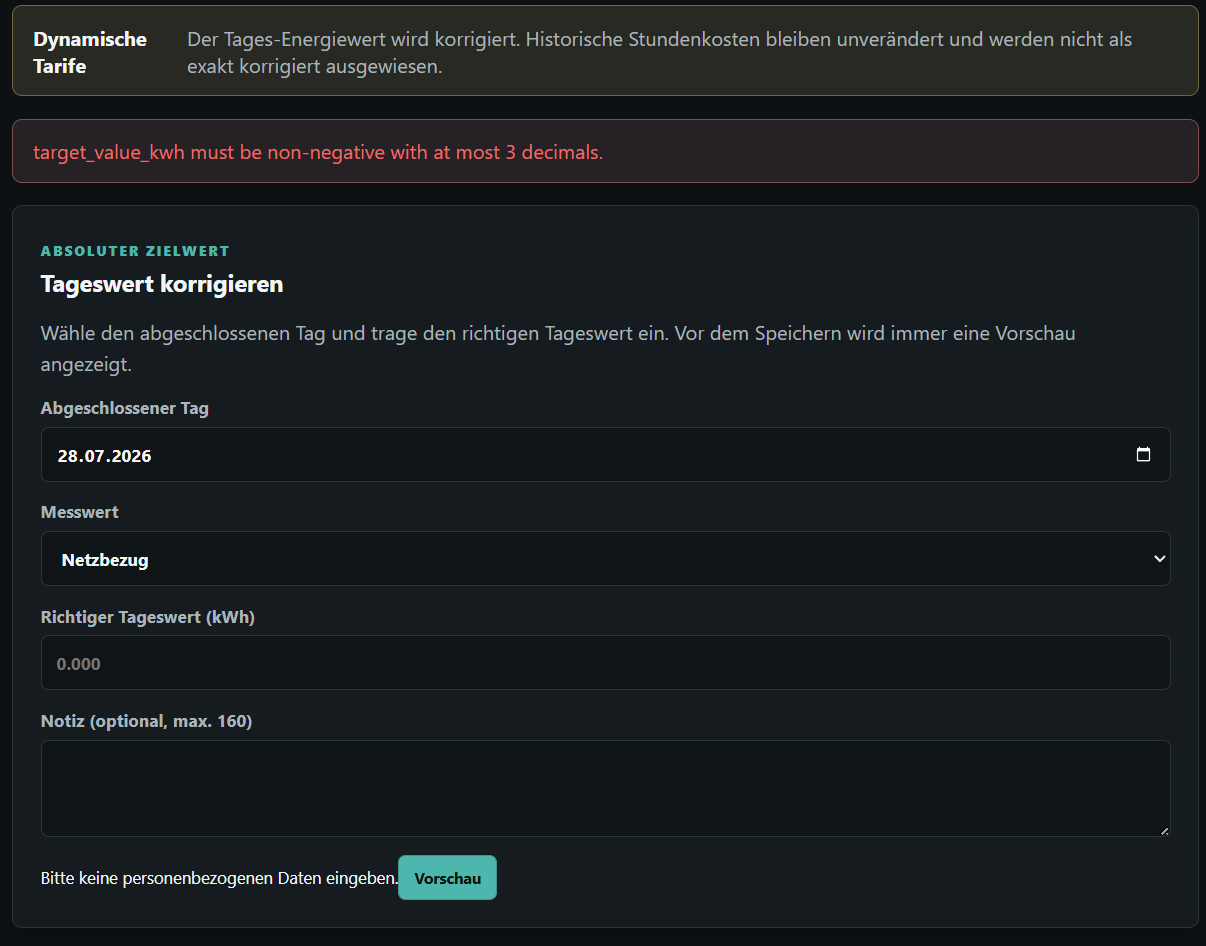
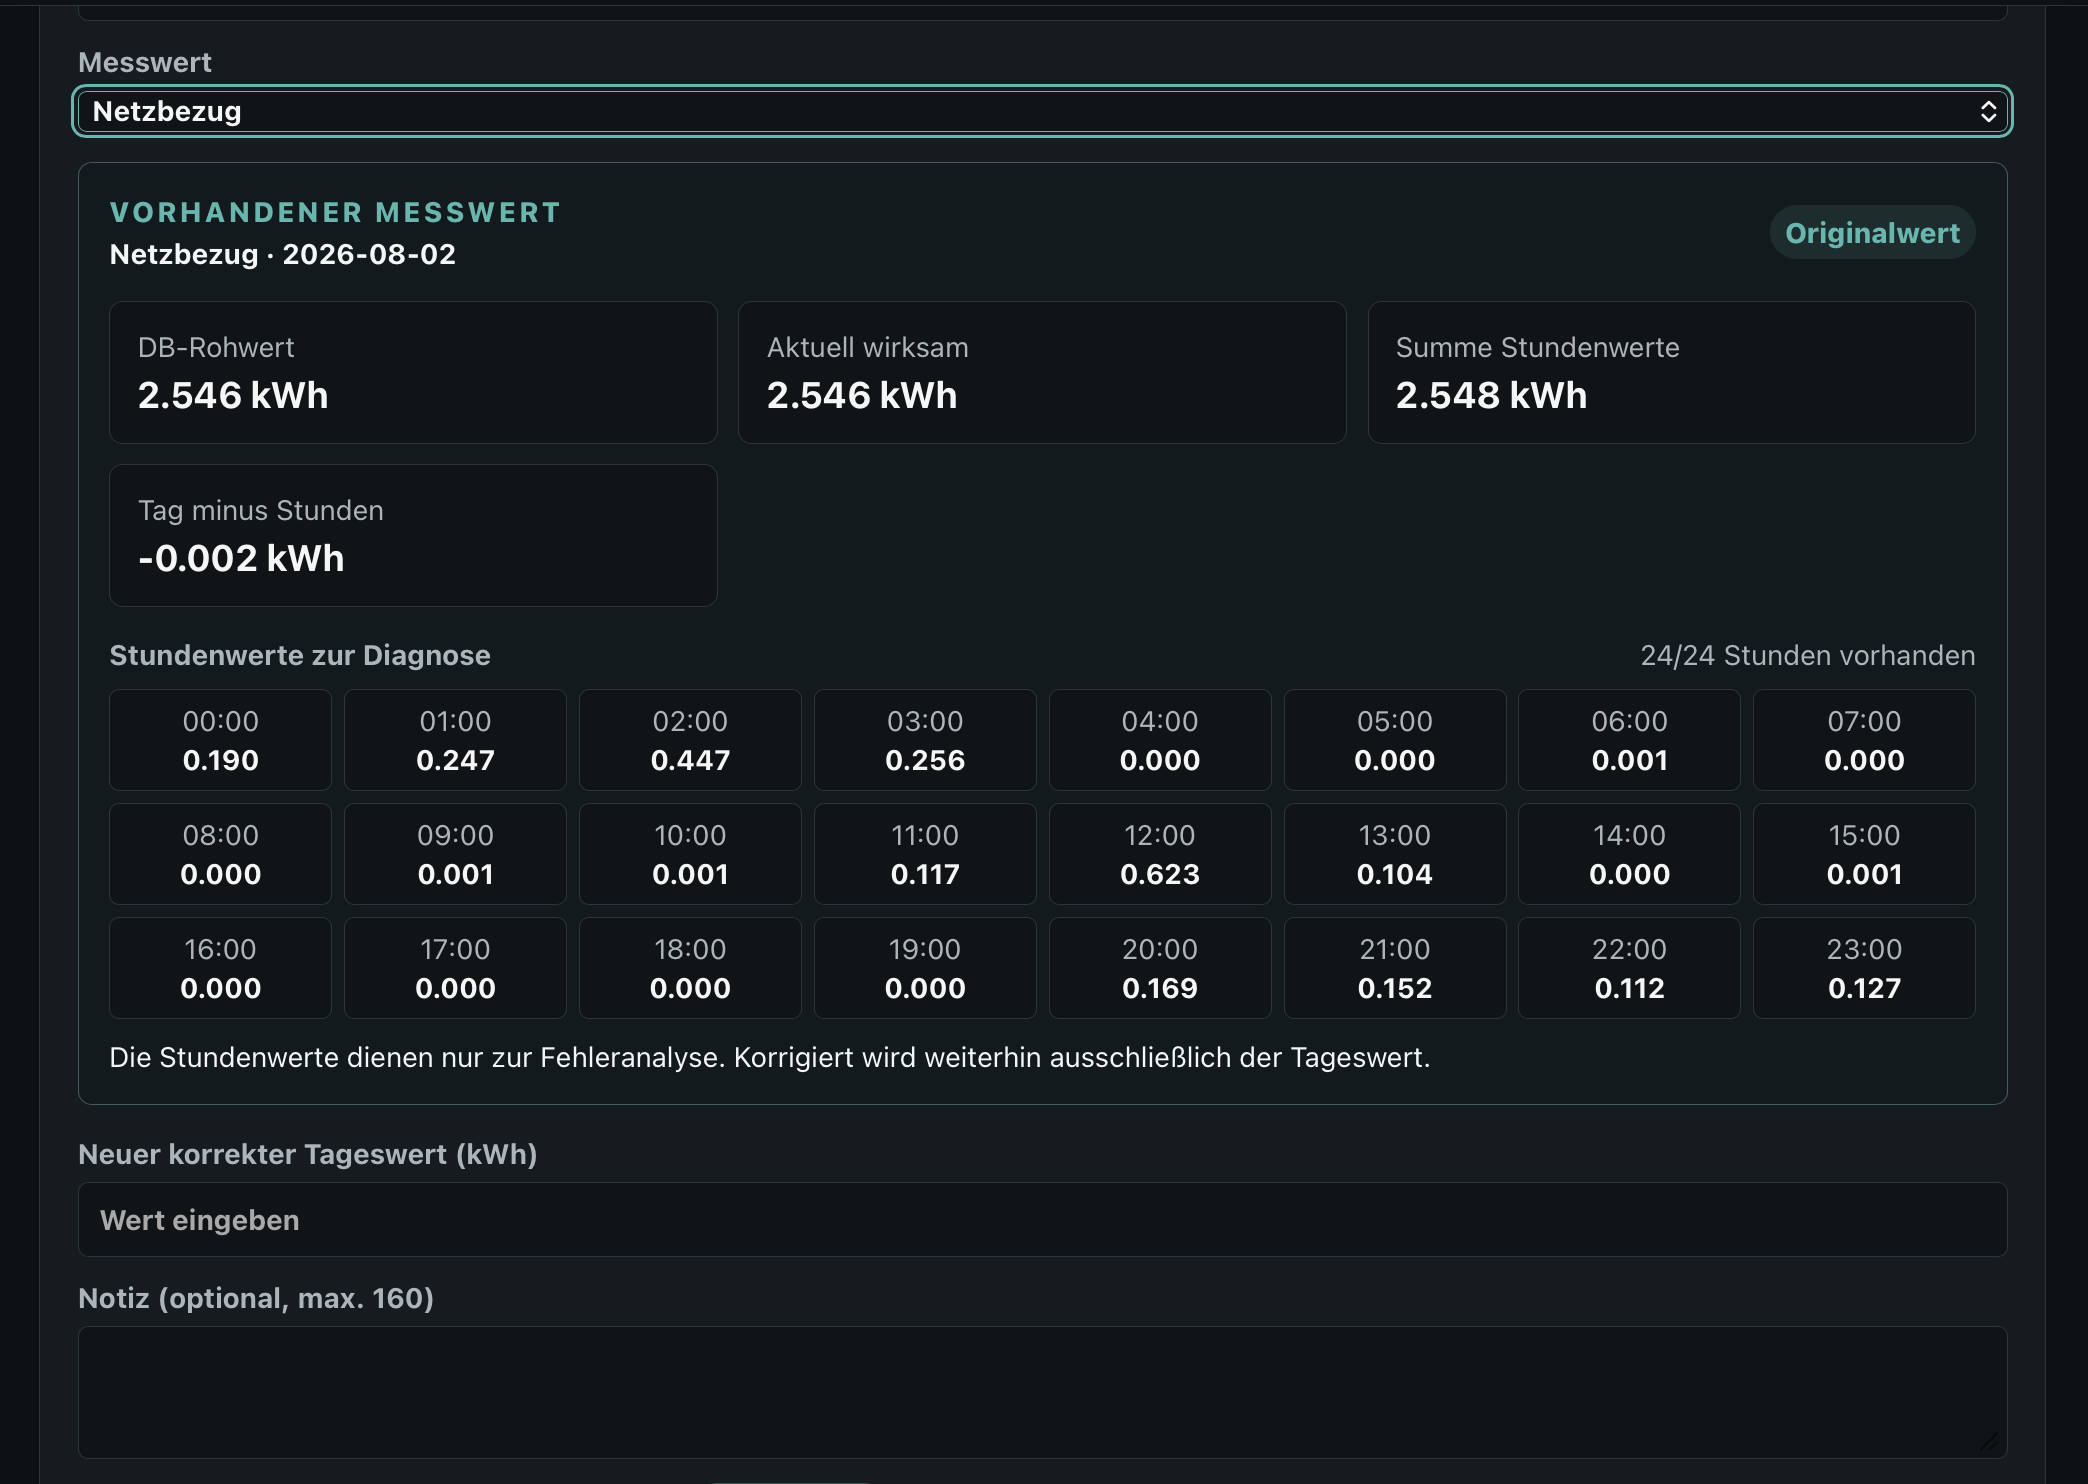
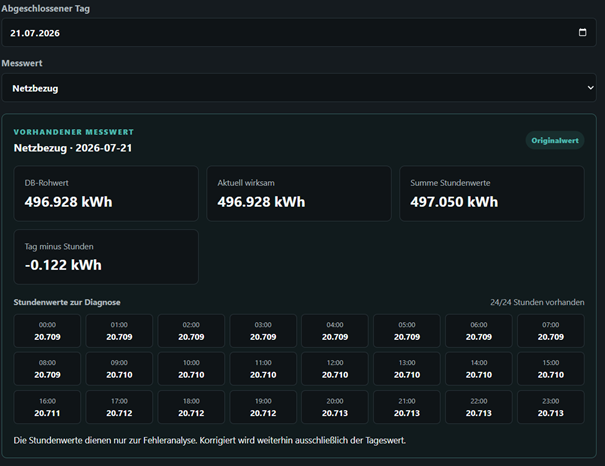
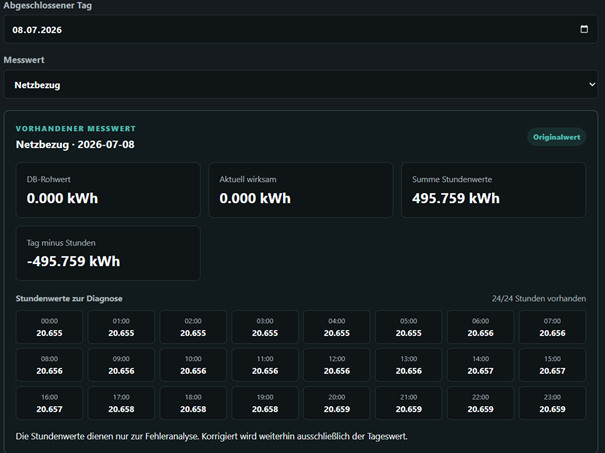
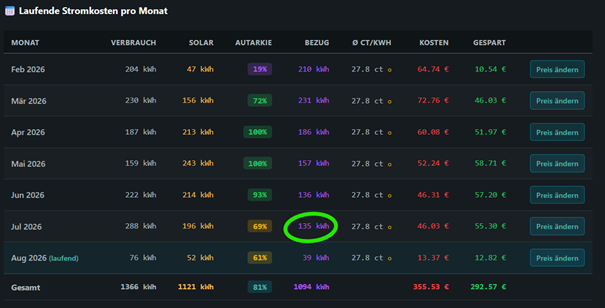
Es hat etwas gedauert, aber nun habe ich verstanden was Du meinst.. im kommeden Update kann man in den Tagen nach den Ausreißern suchen / finden und denn den Tageszähler gezielt korrigieren!
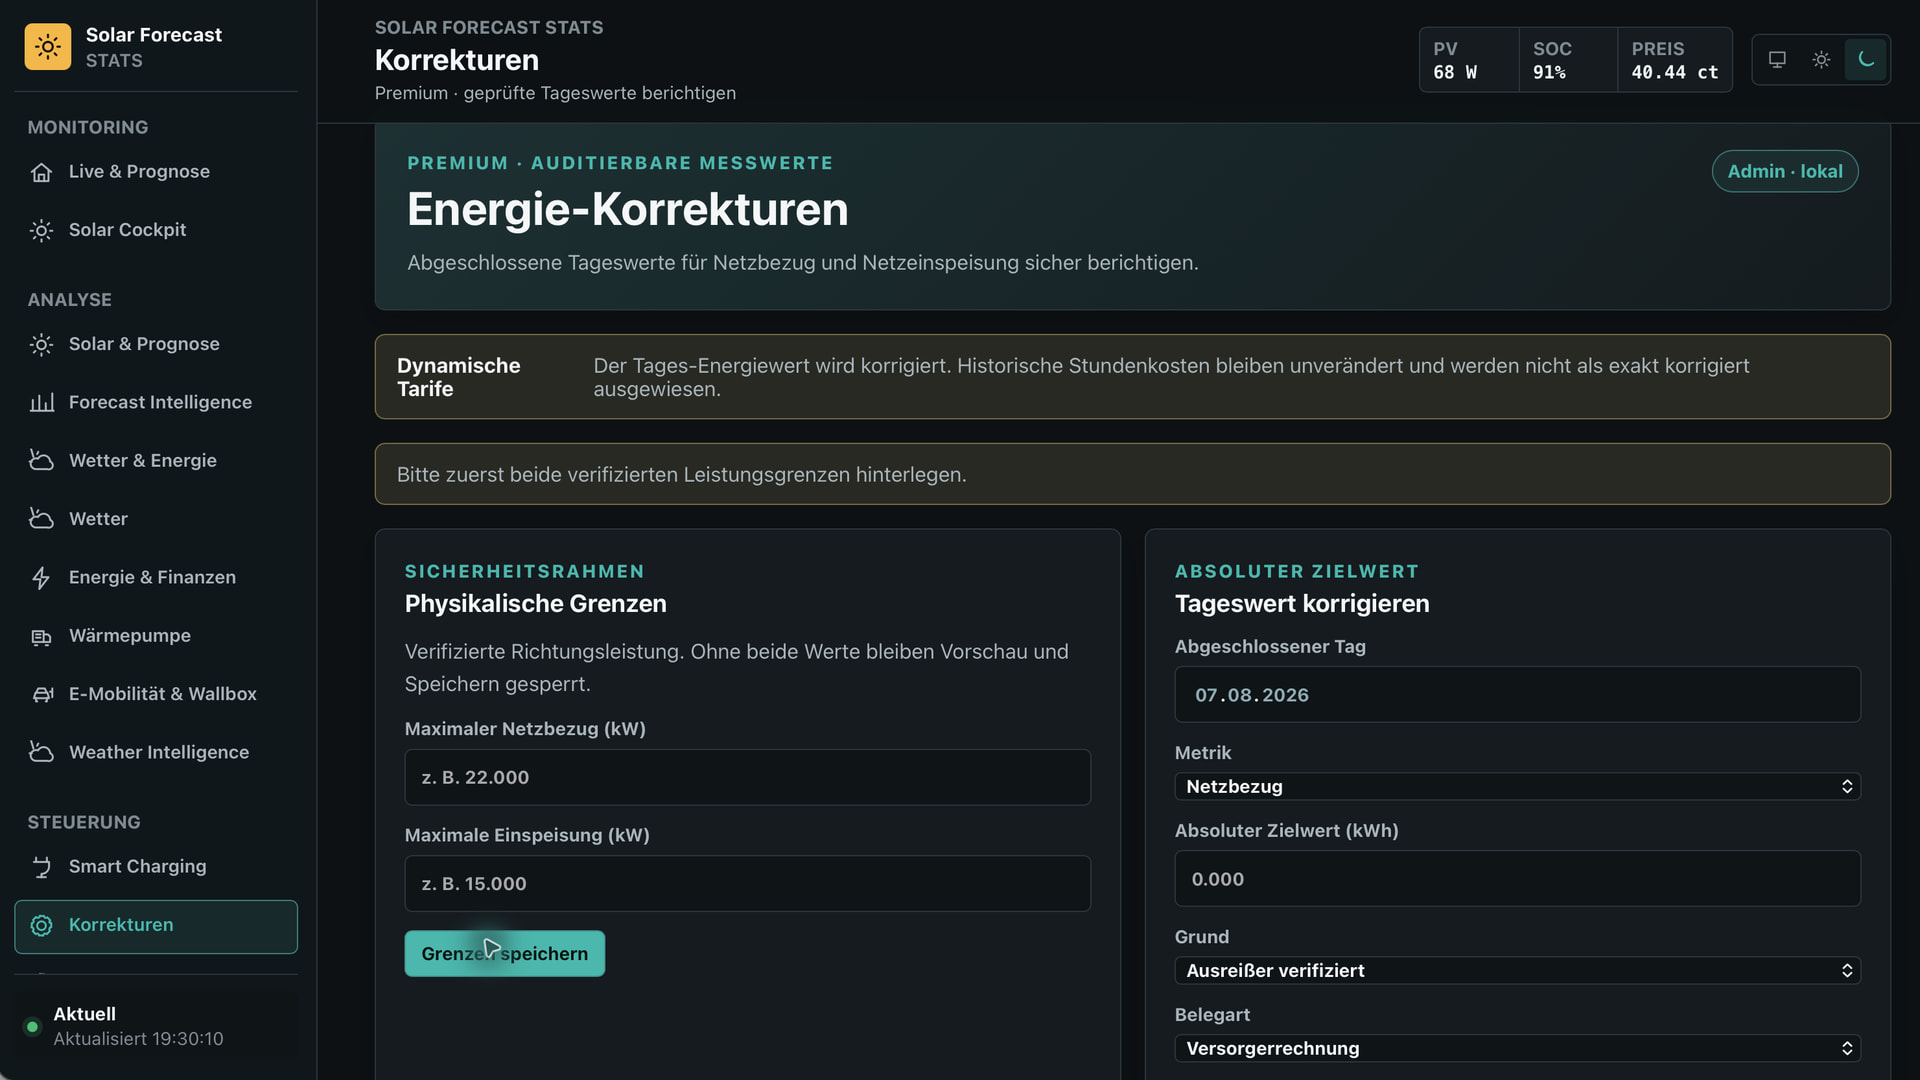
Und was mir jetzt noch aufgefallen ist. Wenn ich dein Beispiel Fenster Korrekturen betrachte, das Fenster "physikalische Grenzen " erscheint gar nicht.
Das ist auch nicht notwendig, die physikalische Grenze wird an anderen Stellen verwendet. Hier geht es nur um genau das was Du angemerkt hast - vielfach angefragt wurde : Werte zu korrigieren anhand der “korrekten” Werte. Diese Werte können ja vom Quell-Sensor / Solar-App / … keine physikalische Grenze “reißen”. Die “echte” Datenbasis kann ja rein von der Logik her nicht größer sein, als das was physikalisch möglich ist. Grundsätzlich ist es aber so das man sich Gedanken machen muss was man da korrigiert.. das kann ich leider niemanden abnehmen.
Ich denke so ist es genau das was gewünscht wurde und ein mächtiges Werkzeug mit dem man 100% HA konform in den Datenbestand von SFML Datenbank eingreifen kann.
Hallo @Wolfi1
vielen Dank! Zu deiner Frage: Weil der “Zähler” ein Tageszähler ist und kein Stundenzähler.
Wäre schön wenn Du es heute Abend schaffst! - Würdest Du bitte anderen notfalls helfen wenn es um das korrigieren geht zum Beispiel @Milkaschokolade .. ich schaffe es zeitlich aktuell nicht
Nein, da die benötigte Leistung dann zu hoch wird und viele Installationen das dann nicht mehr schaffen, wurde bereits mehrfach von Tom erklärt, das es nicht geht. Kannst du nicht einige von den Gruppen zusammen legen? Gegebenenfalls mit Helfern.
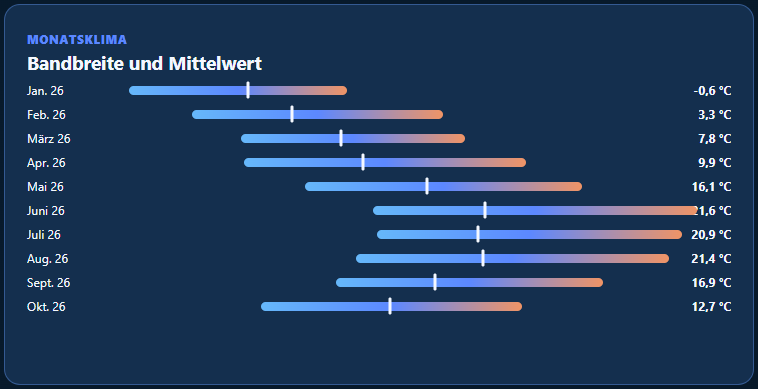
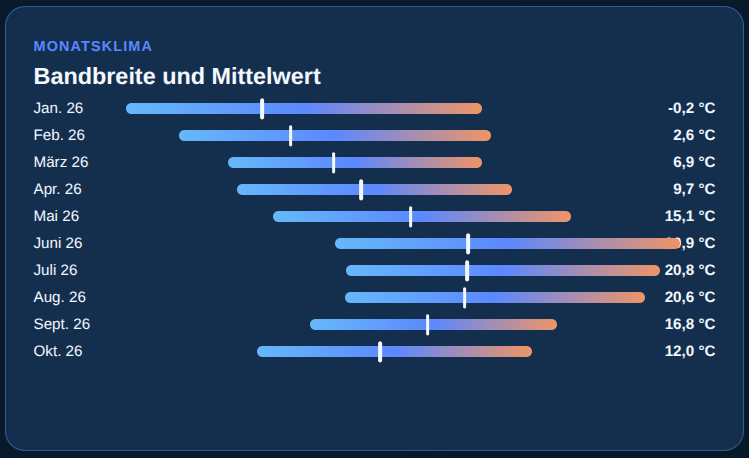
was mir da gleich noch auffällt, der Farbverlauf ist immer der selbe, kälteste temp im monat is blau, höchste Orange, ggf, sollte man die Skala festnageln…oder an das “WetterOnline”
Model anpassen, falls das technisch umsetzbar ist