Ich habe hier HA unter Proxmox am laufen und versuche gerade die Hardware zustände (CPU, RAM, HDD/SSD,…) auszulesen und Grafisch darzustellen.
Leider habe ich bisher keinen weg gefunden.
Habt ihr eine Lösung für mich parat?
Welche willst du auslesen? Cpu der HA VM oder des Hosts?
Geht aber denke ich beides mit der besseren Proxmox Integration. Aus HACS ist die glaube ich.
https://github.com/dougiteixeira/proxmoxve
Kriegst dann ewig viele Sensoren

1 „Gefällt mir“
vielen Dank… ich muss leider gestehen das ich an HACS überhaubt nicht gedacht bzw. es auch noch gar nicht installiert hatte.
Habe mich jetzt damit aber beschäftigt und es nachgeholt.
Ich muss gestehen, das war eines der ersten Sachen, die ich in HA überhaupt eingerichtet habe, meinen Proxmox-Server.
Kann ich empfehlen, das funktioniert sehr gut, der überwacht neben dem Server selber auch alle Linux-Container und VM’s darauf. Aktuell hab ich 22 Dienste und rund 540 Entitäten.
Aktuell hab ich den Proxmox noch parallen in Grafana drin, aber davon will ich weg.
Welche Möglichkeiten habe ich denn gerade die Temperaturen des Hosts auszulesen?
Die Proxmox Integration gibt nur Infos preis, was die “Auslastung” des Nodes bzw der VMs angeht.
Hatte mal die Glances Interation versucht, richtig zufrieden war ich damit aber nicht. Die Werte wurden teils >30min nicht aktualisiert.
Temperature ist so ein Problem, da hab ich für meinen Rechner auch lange gesucht und nichts passendes gefunden, wollte die Daten in Grafana bekommen, weil mein Proxmox-Server öfters mal aussteigt und schwer ein Temperaturproblem in Verdacht habe bei den SSD’s.
Mehr als CPU-Temperaturen und dei der NVMe hab ich nicht rausbekommen
Darf ich fragen wie du die CPU-Temp und die der SSD-Temp übergibst bzw ausließt?
Übergeben garnicht, das wollte ich Grafana / Nodeexporter oder Telegraf lösen, hat aber nur semigut funktioniert, da hab ich das sein lassen.
Man muss entsprechende Software auf dem Proxmox-Debian nachinstallieren welche die Sensoren ausliest. Mein AMD-Prozessor gibt z.b., aber keine Temperature der CPU-Cores selber raus, sondern nur die der Mainboard Sensoren, genauso die SSD’s, nur die NVMe liefert einen Wert.
Daher hab ich mir das ganze am Ende geschenkt.
das googlest am besten, ich bekomms nicht mehr zusammen, was ich alles getestet und installiere habe
1 „Gefällt mir“
Okay, der Thread ist schon älter, aber ich mach ihn nochmal auf:
Ich habe proxmox NVE aus Hacs installiert. Ist okay, aber vieles fehlt was mir wichtig ist:
- Speicherplatzverbrauch von VMs wird nicht angezeigt
- Betriebsdaten einer NVMe-SSD fehlen
- Bestimmte Sensorwerte sind unklar und stimmen nicht mit der Anzeige in Proxmox überein
Ich hab mal versucht checkmk zu installieren in der Hoffnung, dass man ein Dashboard als Internetseite in HA einbinden kann, bin dann aber hoffnungslos gescheitert. Auch andere Alternativen die ChatGPT mir vorgeschlagen hat sind viel zu komplex. Ich betreibe hier kein Atomforschungszentrum …
Schließlich hat Chattie mir vorgeschlagen die JSON direkt auszulesen und eigene Sensoren zu bauen. Das fand ich (anhand der Beispiele) für mich handhabbar - aber allein der Versuch die .json Dateien des Servers über URL auszulesen scheiterten an dem ganzen Sicherheitsoverkill mit API und Authentifizierungsgedöns.
Es muss doch einen Weg geben …
Hallo
Auch wenn ich erst später antworte, ich habe mit chat-GPT eine laufende Lösung erstellt (war ein langer Weg)
unter Benutzer / Sicherheit einen Langlebige Zugriffstoken erstellen, der dann in dem unten aufgeführten Script mit eingepflegt wird
danach
Sensoren auf Proxmox installieren.
apt install lm-sensors -y
dann mittel “nano” die Datei und der Hilfe von Chat-GPT das Script erstellen lassen
hier sind Daten vom System notwendig, lsblk und ggf df -h um die Bezeichnung, HDD und die HA-IP als Info an Chat-GPT weiter zu geben
(hier meine bash-Datei)
#!/bin/bash

#smart-rest-pve-hpg6.sh

PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin

HA_URL=“https://192.168.1.75:8123”
TOKEN=“eyJhbGciOiJ…”   # ← dein gültiges Long-Lived Access Token einsetzen

# Funktion zum Senden eines States an Home Assistant

send_state () {
local entity=“$1”
local value=“$2”
local unit=“$3”
local friendly=“$4”
local icon=“$5”

curl -s -k -X POST
-H “Authorization: Bearer $TOKEN”
-H “Content-Type: application/json”
-d “{“state”:“$value”,“attributes”:{“unit_of_measurement”:“$unit”,“friendly_name”:“$friendly”,“icon”:“$icon”}}”
“$HA_URL/api/states/$entity” > /dev/null
}

# === CPU Usage ===

CPU=$(LC_ALL=C top -bn1 | grep “Cpu(s)” | awk ‘{print 100 - $8}’ | sed ‘s/,/./’)
send_state “sensor.pve_hpg6_cpu_usage” “$CPU” “%” “PVE HPG6 CPU Nutzung” “mdi:chip”

# === RAM Usage ===

RAM=$(free | awk ‘/Mem:/ {printf(“%.0f”, $3/$2 \* 100)}’)
send_state “sensor.pve_hpg6_ram_usage” “$RAM” “%” “PVE HPG6 RAM Nutzung” “mdi:memory”

# === CPU Core Temperaturen (lm-sensors) ===

CORE_TEMPS=$(sensors | grep -E “Core \[0-9\]” | awk ‘{print $3}’ | tr -d ‘+°C’)
i=0
echo “$CORE_TEMPS” | while read TEMP; do
send_state “sensor.pve_hpg6_core${i}\_temp” “$TEMP” “°C” “PVE HPG6 Core $i Temperatur” “mdi:thermometer”
i=$((i+1))
done

# === SMART Werte (Temperatur, Health, Abnutzung) ===

for disk in nvme0n1 nvme1n1 sda; do

# Temperatur

TEMP=$(smartctl -A /dev/$disk | awk ‘/Temperature:/ {print $2; exit}’)
if \[ -z “$TEMP” \]; then
TEMP=$(smartctl -A /dev/$disk | awk ‘/Temperature_Celsius|Airflow_Temperature_Cel/ {print $10; exit}’)
fi
if \[ -n “$TEMP” \]; then
send_state “sensor.pve_hpg6\_${disk}\_temperatur” “$TEMP” “°C” “PVE HPG6 $disk Temperatur” “mdi:thermometer”
fi

# Zustand (Health)

HEALTH=$(smartctl -H /dev/$disk | awk ‘/SMART overall-health self-assessment test result:/ {print $6}’)
if \[ -n “$HEALTH” \]; then
send_state “sensor.pve_hpg6\_${disk}\_zustand” “$HEALTH” “” “PVE HPG6 $disk Zustand” “mdi:alert-circle”
fi

# Abnutzung (nur bei NVMe)

if \[\[ $disk == nvme\* \]\]; then
WEAR=$(smartctl -A /dev/$disk | awk ‘/Percentage Used:/ {print $3}’ | tr -d %)
if \[ -n “$WEAR” \]; then
send_state “sensor.pve_hpg6\_${disk}\_abnutzung” “$WEAR” “%” “PVE HPG6 $disk Abnutzung” “mdi:progress-wrench”
fi
fi
done

# === Disk Usage (df -h) ===

df -h -x tmpfs -x devtmpfs | tail -n +2 | while read line; do
MOUNT=$(echo $line | awk ‘{print $6}’)
USE=$(echo $line | awk ‘{print $5}’ | tr -d ‘%’)

case $MOUNT in
/)
send_state “sensor.pve_hpg6_root_belegung” “$USE” “%” “PVE HPG6 Root Belegung” “mdi:harddisk”
;;
/mnt/pve/zwei_tb_sda)
send_state “sensor.pve_hpg6_zweitb_hdd_belegung” “$USE” “%” “PVE HPG6 ZweiTB HDD Belegung” “mdi:harddisk”
;;
/mnt/pve/zwei_tb_ssd)
send_state “sensor.pve_hpg6_zweitb_ssd_belegung” “$USE” “%” “PVE HPG6 ZweiTB SSD Belegung” “mdi:harddisk”
;;
/mnt/pve/pve-small-ha-backup)
send_state “sensor.pve_hpg6_backup_share_belegung” “$USE” “%” “PVE HPG6 Backup-Share Belegung” “mdi:nas”
;;
/mnt/lxc_shares/pve_small_16TB/movies)
send_state “sensor.pve_hpg6_movies_share_belegung” “$USE” “%” “PVE HPG6 Movies-Share Belegung” “mdi:nas”
;;
esac
done
(Ende bash-Datei)
die Datei ausführbar machen und in die crontab -e in Proxmox eintragen. Bei mir werden die Daten alle 5 Min übertagen
Am Ende sieht es so ungefähr aus, die Belegung der Festplatten ist auch noch möglich, habe ich aber zur Zeit noch nicht visualisiert
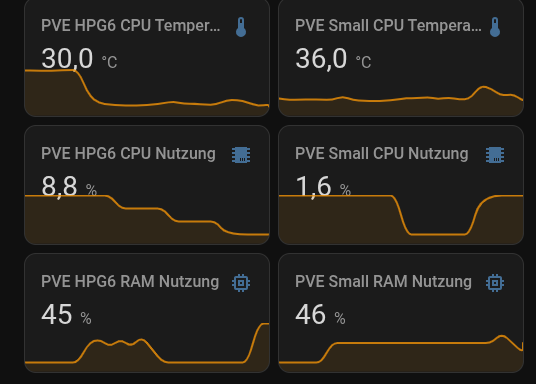
Es brauchen keine Sensoren in HA angelegt werden, die kommen via bash-Script direkt ins HA rein
Vielleicht ist das ein Ansatz
Über Eure Rückmeldung würde ich mich freuen, vielleicht geht es ja noch besser!
Gruß aus NRW
Moin,
Respekt, wer es selber macht 
Aber ich nutze da dann doch lieber die Proxmox eigene Integration
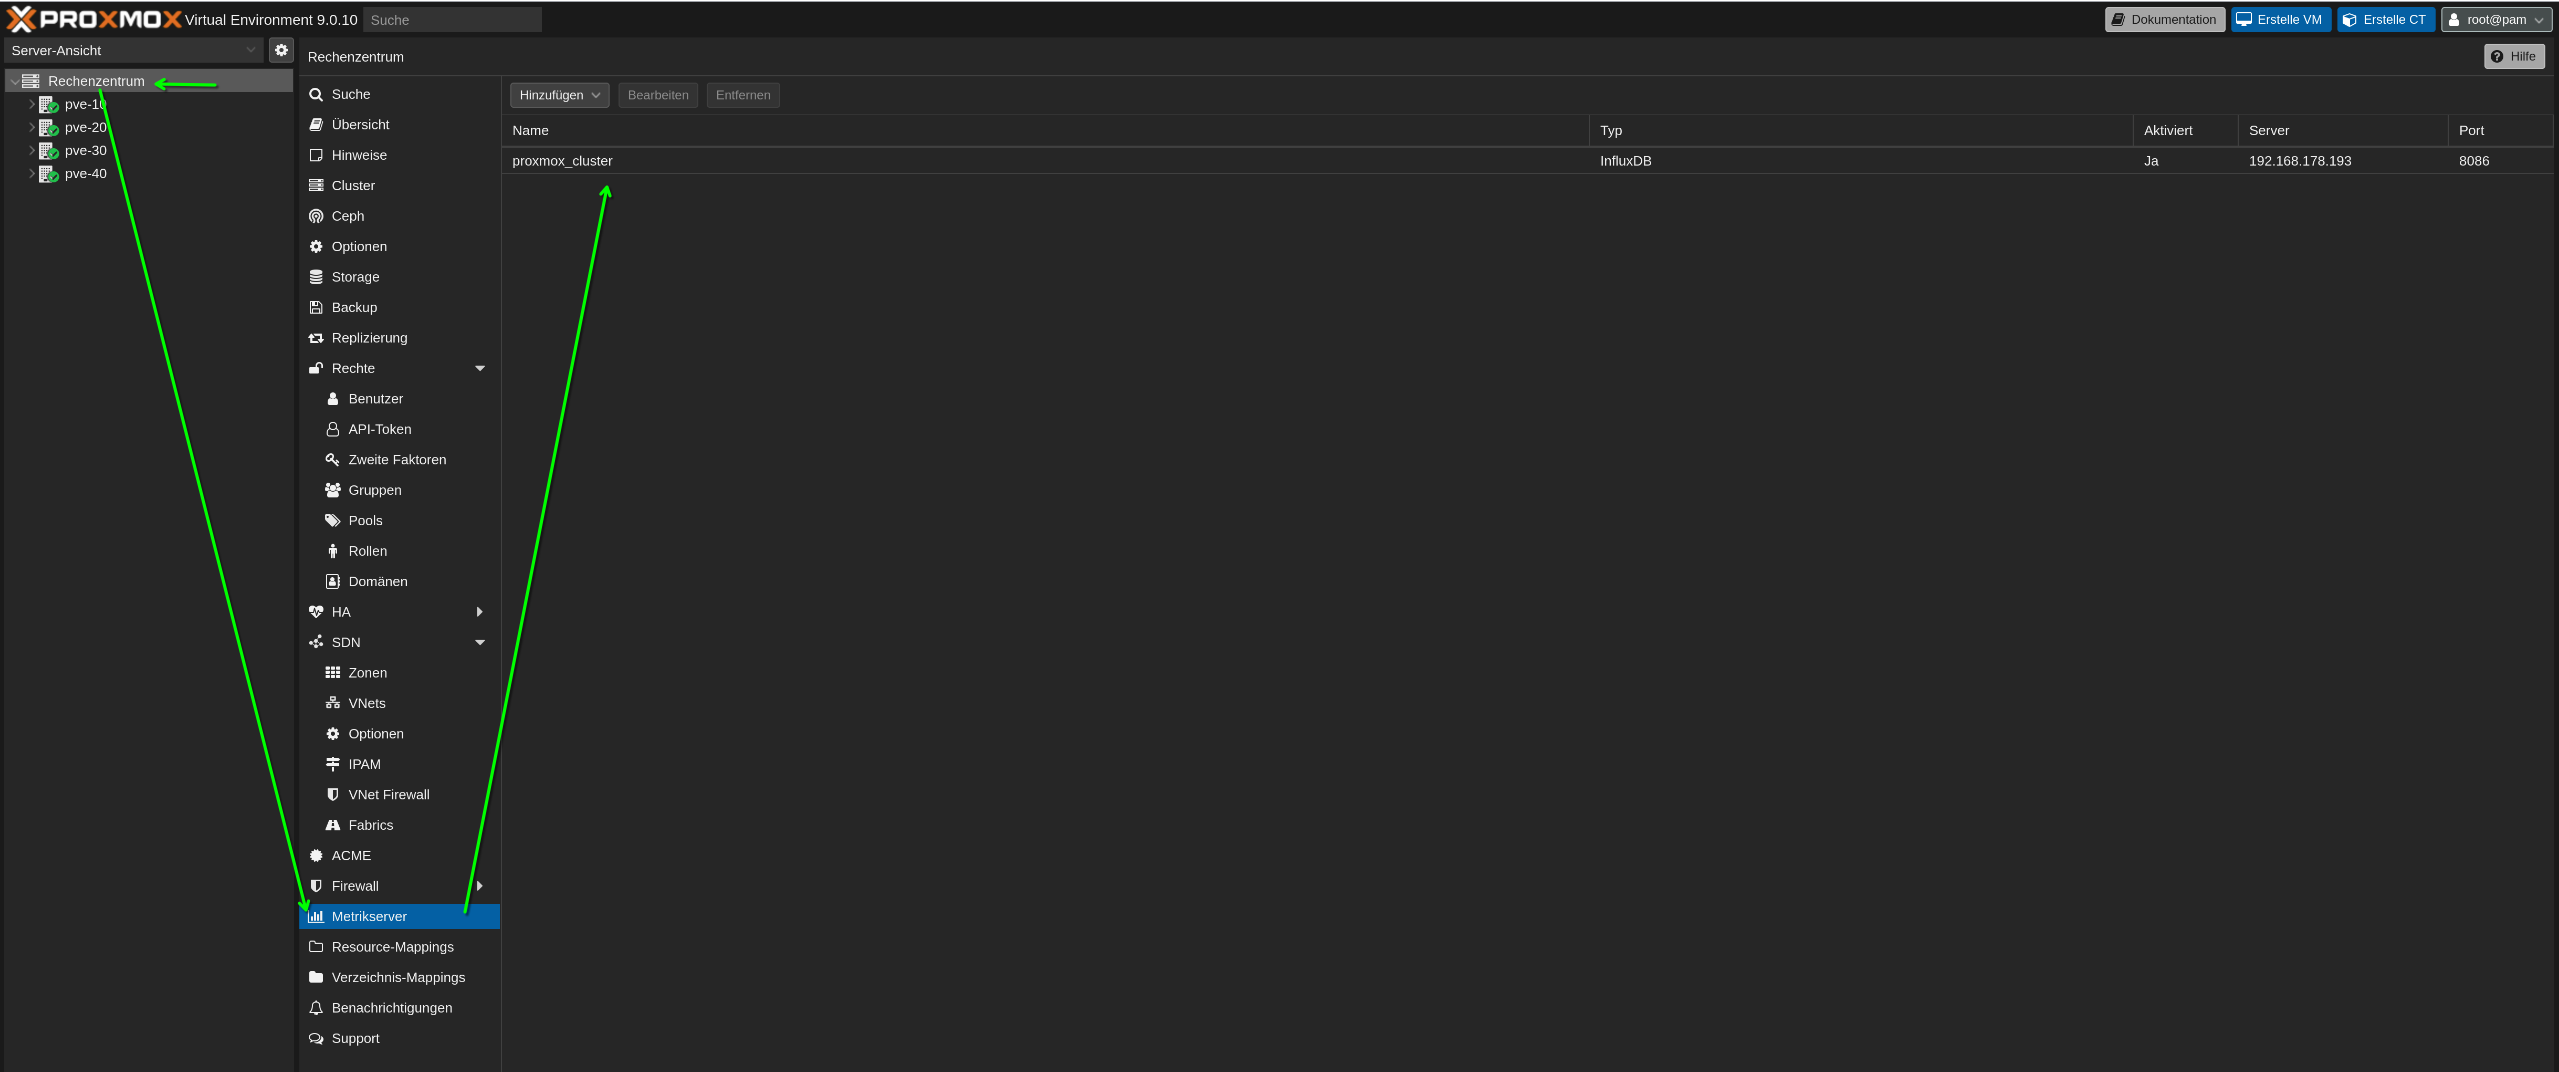
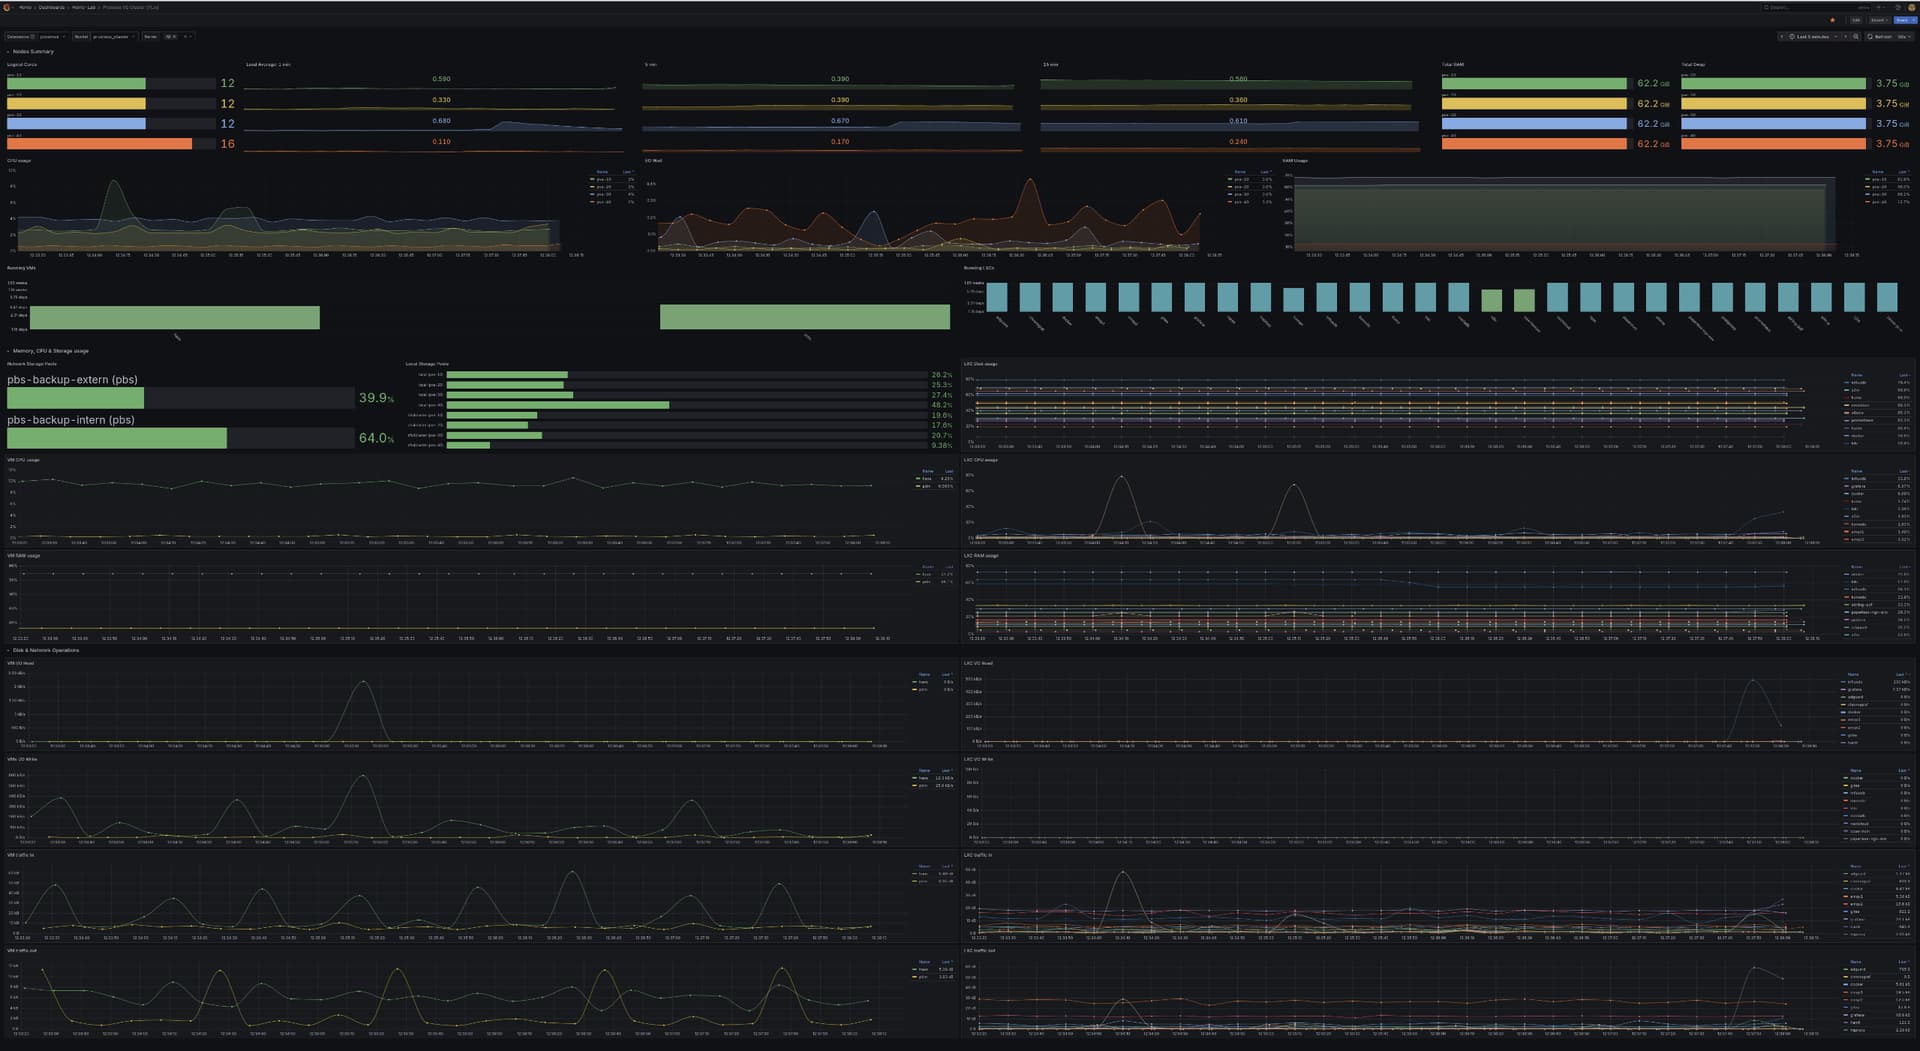
Und dann in Grafana ein Dashboard anlegen
Einmal eine Gesamtübersicht
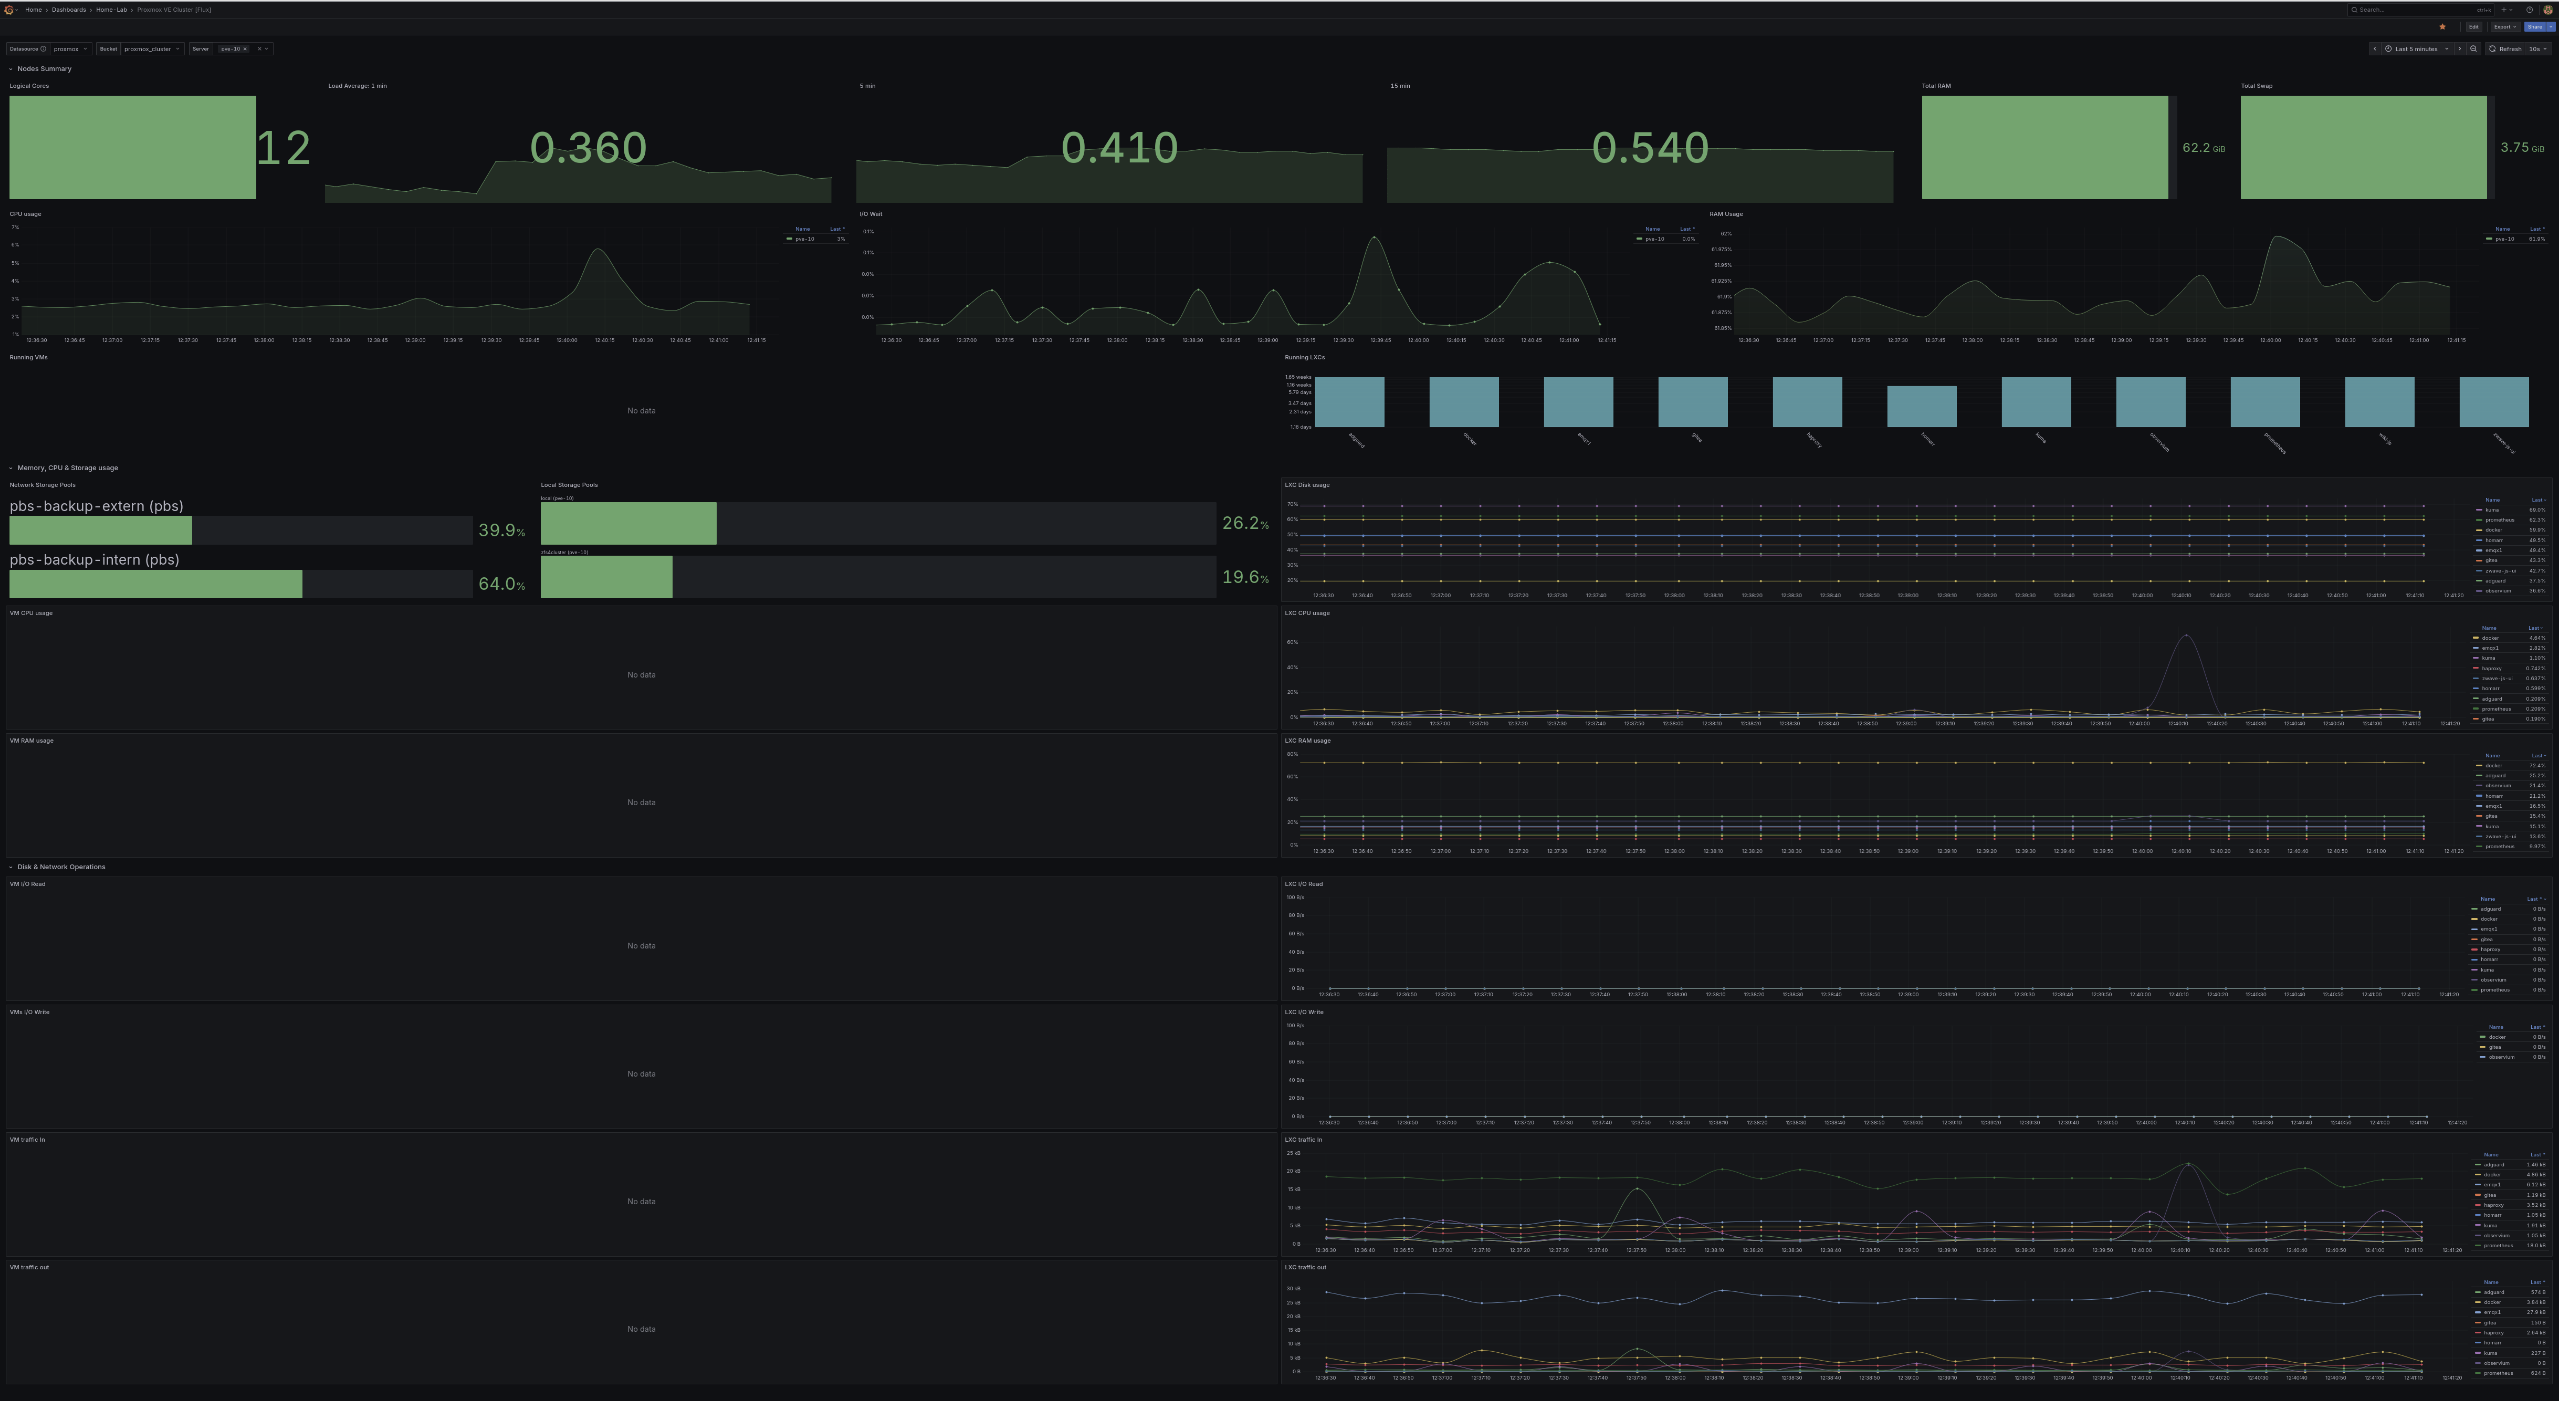
Da kann man dann auch in die einzelnen Cluster Nodes anschauen, wenn man Information braucht
Wenn mich das dann in HA interessieren würde, dann würde ich da ein eigenes Dashboard erstellen und das Dashboard dort importieren.
Temperatur geben meine Mini-PCs nicht preis, da muss ich noch mal schauen, ob ich da etwas ändern kann, vielleicht mit einem D1 und externen Sensor

VG
Bernd
P.S: Korrektur, die Temperatur bekomme ich doch, der Treiber ist schon im Kernel, habe mich da irritieren lassen, weil lm-sensors da nichts gefunden hat. Dann mal schauen wie ich das in mein Dashboard bekomme.
root@pve:~# sensors
nvme-pci-0100
Adapter: PCI adapter
Composite:    +30.9°C  (low  =  -0.1°C, high = +82.8°C)
                       (crit = +84.8°C)
Sensor 1:     +31.9°C  (low  = -273.1°C, high = +65261.8°C)

r8169_0_200:00-mdio-0
Adapter: MDIO adapter
temp1:        +48.5°C  (high = +120.0°C)

coretemp-isa-0000
Adapter: ISA adapter
Package id 0:  +40.0°C  (high = +80.0°C, crit = +100.0°C)
Core 0:        +40.0°C  (high = +80.0°C, crit = +100.0°C)
Core 1:        +39.0°C  (high = +80.0°C, crit = +100.0°C)

nvme-pci-0300
Adapter: PCI adapter
Composite:    +32.9°C  (low  =  -0.1°C, high = +82.8°C)
                       (crit = +84.8°C)
Sensor 1:     +32.9°C  (low  = -273.1°C, high = +65261.8°C)


Was für Kisten hast Du da denn jetzt genau im Einsatz? Welche mit N100/N150 oder mit AMD CPU? Weil die N100 CPU sollte ja eigentlich auch die Temp. liefern. Bsp.:
CPU Intel(R) N100, 4 cores:

sensors
coretemp-isa-0000
Adapter: ISA adapter
Package id 0: +51.0°C (high = +105.0°C, crit = +105.0°C)
Core 0: +49.0°C (high = +105.0°C, crit = +105.0°C)
Core 1: +49.0°C (high = +105.0°C, crit = +105.0°C)
Core 2: +49.0°C (high = +105.0°C, crit = +105.0°C)
Core 3: +50.0°C (high = +105.0°C, crit = +105.0°C)
Edit: Ich hatte Dein PS nicht gesehen, bzw. hattest Du das ja nachgetragen. 
VG Jim
Übersehe ich etwas, oder habe ich die Anforderung falsch verstanden? Es gibt doch eine offizielle Integration fürs Monitoring von Proxmox?
Und eine custom Integration, die umfangreicher sein soll:
Kann aber zu beiden nicht sagen, wie gut die sind. Da ich sie nicht nutze.
Edit: @totow benutzt oder benutze die custom Integration:
Moin,
hatte ja in meinem P.S. schon geschrieben, dass ich mich da hab täuschen lassen von sensors-detect, für meine CPU ist das schon im kernel enthalten, ich muss da nichts mehr einrichten, konfigurieren 
Intel kommt mir nicht ins Haus
Ich denke, Du siehst das schon korrekt, aber und da hört es für mich auf, ich nutze HA als Hausautomation, nicht als Monitoring für meinen PC, oder Server Cluster, das sind mir zu viele Dinge, die nichts mehr mit dem eigentlichen System zu tun haben, ist natürlich jedem selbst überlassen, allen möglichen Kram in HA zu stopfen, ich mache das nicht.
VG
Bernd
Eben an diese Aussage von Dir kann ich mich auch noch erinnern, aber eben auch das Du hier ja auch immer mal wieder diese China Kisten mit N100/N150 empfiehlst/erwähnst. Daher war ich mir nicht mehr sicher was Du jetzt aktuell selber einsetzt und ob die scheinbar fehlende Temp.-Anzeige ggf. an einer AMD-CPU liegt.
VG Jim
Moin,
das tue ich nur, weil oft halt ein Preislimit gesetzt wird, ich werde / würde immer eine AMD CPU mit much more Kernen einer N100 / N150 Intel CPU, mit ihren vier Kernen, vorziehen
Meine Vorfahren waren Schwaben und somit schaue ich auch auf die Kosten, aber ich kann halt auch Rechnen, und da sind mir 70 - 80 € mehr, für eine AMD Kiste, lieber als alle 6 Monate etwas Neues zu kaufen.
Außerdem setze ich das immer, in vergleich zu einem RasPI, wo ich mehr bekomme, aber von den Kosten mich auf gleichem Niveau bewege.
Wenn ich könnte, wie ich gerne wollte, würde hier etwas ganz anderes seinen Dienst verrichten, ein Ampere ARM CPU mit >=128 Kernen 
VG
Bernd
Bei AMD CPUs war ich mich nicht sicher ob diese auch die CPU-Temp. per sensors liefern, was daran liegt das ich z.B. mit Intel CPUs “aufgewachsen” bin und in jetzt über 30 Jahren mit Computern zu Hause noch nie eine Kiste mit AMD CPU hatte. Also eher das Gegenteil von Dir, sprich eine AMD CPU kommt mir nicht ins Haus. Ist halt das “Gewohnheitsding”.
Aber das ist jetzt ja auch schon wieder OT und wichtig ist bzgl. dem Proxmox Monitoring ja das sowohl die Intel, als auch die AMD CPUs, die Temp.-Werte liefern.
Edit und noch ein wenig OT:
Ach was kostet die Welt. So’ne Ampere Altra Max M128-26 Workstation mit 128 x 2.6GHz gibt es doch schon ab rund € 5.000.  Damit lernt Dein Proxmox und Deine HA LXC dann das fliegen.
VG Jim
Hallo Bernd,
darf ich mal fragen wie Du es realisiert hast?
Das sieht schon richtig gut aus, ich denke die Daten kommen in Echtzeit? Nicht so wie bei mir, da werden die via Cron alle 5 Minuten ins HA geschickt.
Wäre genial einen Hiweis zu bekommen.
InflusDB kenne ich noch nicht.
Danke und Gruß
Moin,
worauf beziehst Du diese Frage?
Auf meine Diagramme, 7 Posts weiter oben?
Ja, das sind Daten, die Proxmox so schickt wie sie anfallen. Um das umzusetzen, muss man influxDB und Grafana einrichten, dann in Proxmox den Metrikserver einrichten, siehe erstes Bild
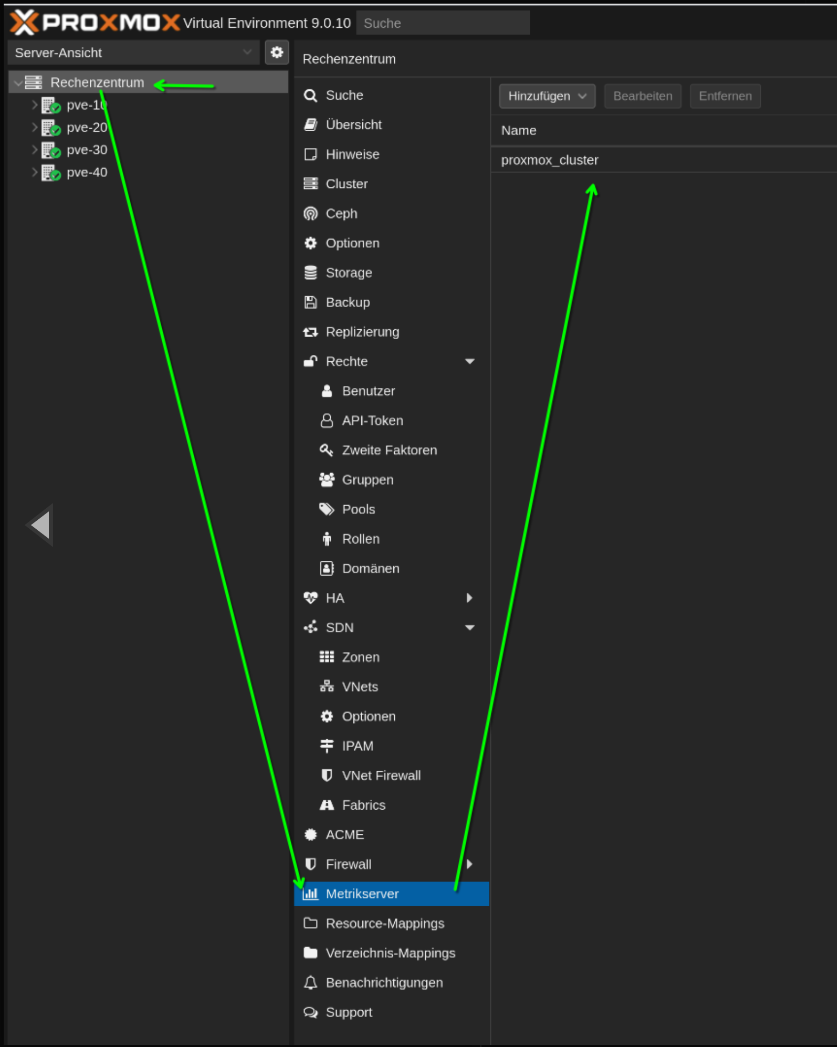
Wenn die daten in der Datenbank ankommen, dann muss man in
Grafana die influxDB als Datasource einrichten und dann von der Grafana Seite das Proxmox-Dashboard herunterladen, z. B. das hier
Eine Anleitung findest Du auch hier,
VG
Bernd
1 „Gefällt mir“
Hallo Bernd, das werde ich mir am WE einmal tiefer anschauen, starke Zusammenfassung und DANKE