Bin ich der Einzige der nicht versteht, wieso man von einem Gerät das die eigene Hausautomatisierung steuern soll gleichzeitig erwartet, dass es Auskunft zur weltpolitischen Lage gibt? 
@tarag mein Gedanke dabei ist recht einfach: Ich möchte mit dem VPE die Echos ersetzen. Die Präsidenten-Frage war nur ein Test.
Ersetzen möchte ich genau genommen diese Funktionen (alles nicht besonders wild, sondern Standard):
- Steuerung Smart Home
- Uhrzeit abfragen - klappt
- Wetter - ich hab die Meteorologisk Integration in HA, VPE greift aber nicht darauf zu und nennt mir kein Wetter. Hat jemand einen Rat?
- Nachrichten - bei Alexa und Google home hab ich Tagesschau in 100 Sekunden und Deutschlandfunk hinterlegt (bei Alexa mit Skills, bei Google home weiß ich es nicht mehr). Was muss ich machen, um VPE diese Nachrichten vortragen zu lassen?
- Musik: Spotify und Webradio (z. B. Radio Bob). Im Gegensatz zu Alexa werden Google home und VPE von Music Assistant unterstützt. Da hab ich noch die Idee, meine alten Stereoanlagen-Boxen (passiv, alt, aber klingen gut) mit einem Stream-Amp zu verbinden. Würde der VPE in Verbindung mit einem WiiM Vibelink Amp ausreichen, um Spotify und Webradio zu hören? Oder doch eher ein richtiger Streaming-Client / Verstärker wie z. B. dem WiiM Amp Ultra?
Danke für den Tipp, hab wieder auf Okay Nabu gestellt und das funktioniert tatsächlich einen Tick besser. Leider immer noch nicht ganz so gut wie die Echos, aber mal schauen, ob sich da auch noch was verbessert.
Die Sprechpausenerkennung hab ich auf aggressiv und die Wake word sensitivity auf very sensitive gestellt.
Wir vergleichen hier offene Hardware und Systeme mit einem Werbeprodukt eines internationalen Milliarden Unternehmens, das zu den reichsten der Welt gehört.
Ich verstehe total, was Du meinst.
“leider immer noch nicht” bedeute, dass meine Erwartung zu hoch war und ich somit enttäuscht wurde. Ein paar Tage später ist das natürlich dämlich… 
Die Entwicklung von Home Assistant und dem Voice PE ist großartig! Ich freue mich total, dass es eine Community gibt, die sich den Arsch aufreißt, um etwas zu entwickeln und voranzutreiben, das auf Funktion optimiert ist und nicht als stumpfe Gelddruckmaschine ohne großartige Fortschritte dient.
Amazon hat mit den Echos mal den Google home Geräten und Siri den Rang abgelaufen. Bessere Spracherkennung als Siri und Google home, schlauer als Siri (aber doofer als Google Assistant). Google hat den Home Max nicht nach Deutschland gebracht, Amazon hat den Echo Studio, Apples großer Homepod ist meines Wissens aber klanglich die Nr. 1 (das Problem mit den fehlenden Mitten, ist hier meines Wissens nicht so schlimm). Preislich wurden einem die Echos im Vergleich mit den anderen beiden hinterher geworfen.
Die Alexa-App ist aus meiner Sicht die schlechteste und unlogischste Smarthome App. Die Idee mit den Skills fand ich anfangs noch echt toll. Mittlerweile ist das einfach nur noch Mist. Die Google home App war früher eher so semi. Jetzt funktioniert sie sehr gut. Siri ist nach wie vor Quatsch, aber Apples Homekit ist sehr stark.
Aktuell ist aus meiner Sicht die beste Kombi HA als Plattform, Google home greift alles ab und Gemini als Sprachsteuerung.
Aber ich bin mir sicher, das HA die Software hinter Voice PE so weiter entwickelt, dass VPE Kommandos mindestens auf dem Niveau von Alexa versteht.
Fazit: Durch den Fokus auf so viel Geld wie möglich zu verdienen und der Politik, nicht auf Kunden zu hören, sondern sie zu bevormunden, hat HA mit dem VPE sehr große Chancen, in der Funktionsweise alle zu übertrumpfen!
Guten Abend zusammen und allen noch ein frohes neues Jahr gewünscht.
Offensichtlich waren meine Erwartungen an den Voice Assistant zu hoch.
Da mein Google Max-Speaker meine Freundin sehr schlecht “versteht” wollte ich den Voice Assistant ausprobieren.
Aber der versteht selbst mich so gut wie nie. Wenn ich ein paar Stunden nicht mit ihm “geredet” habe, reagiert er auf keines der Wakewords (habe 2 hinterlegt). Erst wenn ich den Knopf drücke, regiert er anschliessend wieder ein paar mal auf das Wakeword.
Befehle führt er eigentlich nie aus. Ein einfaches “Esstisch ein” wird mit einem “Das habe ich nicht verstanden” quittiert. Variationen wir “Schalte Esstisch ein” oder “Licht Esstisch einschalten” funktionieren genau so wenig. (An der Stelle ist Google doch deutlich toleranter).
Was ebenfalls merkwürdig ist: Je nach verwendetem Wakeword, erhalte ich die Antwort von einer anderen Stimme.
Ich weiss nicht, wie tief eine Erwartung sein soll, um nicht von der “Leistung” enttäuscht zu sein.
Gibt es irgendwelche Fallstricke bei der Einrichtung? Ist das Gerät vielleicht sogar defekt?
Viele Grüsse
Oliver
Mir geht es genauso.
Ich habe das Gerät mehr als ein halbes Jahr und habe aufgegeben ihm irgendeinen Nutzen abzugewinnen. Er reagiert aufs Radio, auf den Fernseher, aber fast nie auf ein Kommando nach dem Wake Word. Man muss so nah herangehen und extrem deutlich sprechen. Da kann ich gleich das Handy nehmen und auf einen Button drücken.
Was völlig verrückt ist, dass er manchmal mitten in der Nacht anfängt irgendetwas nicht zu verstehen. Also komplett ohne eine Geräuschquelle, reagiert er plötzlich und erzählt, dass er es leider nicht verstanden hat.
Auch wenn es eine Preview Edition ist, hatte ich da schon mehr Hoffnungen reingesteckt.
Es kommen ja auch immer mal wieder Updates, aber am grundlegenden Problem ändert sich nichts.
Arbeitet ihr ausschließlich local, über NABU casa? Oder wie?
Und auf welcher Hardware?
Ich habe in allen Zimmern einen Home Assistant Voice Preview.
Bei “fremden” Stimmen (bei Telefonaten im Home Office, sehr selten auch nal bei Sprache aus dem TV) aktiviert er sich manchmal unerwünscht. Bei Musikwiedergabe habe ich kein Problem.
Ich habe daher eine Automatisierung erstellt, die das Mikro abschaltet, solange mein Arbeits-Laptop läuft.
HA läuft auf einem NUC mit N150 und 16GB RAM. Für STT und TTS verwende ich die HA Cloud (Nabu Casa). Mit Wisper verlängert sich die Reaktionszeit deutlich bei und Piper habe ich keine Stimme gefunden, die mir gefiel.
Damit komme ich gut zurecht. Ich habe noch vier Satz-Automatisierungen erstellt: Wetter-Ansage, Quittierung meiner Warn-LEDs, Heizungs-Boost ein/aus und Abspielen meiner Musikbibliothek. Mehr war bisher nicht notwendig.
Ja, wenn man weiter weg ist, muss man seine Stimme ergeben.
Und ja, manchmal man muss sich auch etwas trainieren, damit man den richtigen Satz sagt (Beispiel: OK Nabu, stell einen Timer auf xx Minuten, und nicht mit oder für).
Mein Sprachassistent läuft primär über die Cloud.
HA habe ich als Image auf einer Synology NAS laufen.
Welches Modell genau? Die üblichen Consumer-NAS von Synology dürften etwas schach auf der Brust sein, um damit eine vernüftige Sprachsteuerung über HA und dem Voice Teil zu realisieren. Auf jeden Fall wenn es da um eine rein lokale Sprachsteuerung geht.
VG Jim
Bin auch auf einem Intel NUC unterwegs und nutze das Ding via HACloud, weil schweizerdeutsch gibts nur da. Aber abgesehen davon das „Hey Jarvis“ eigentlich nur bei unserem 8 jährigen Sohn funktioniert, klappt das besser als erwartet. Liegt auch daran das die wakewords englisch sind und wenn Tonlage etc nicht stimmen reagiert der VoicePE nicht.
Es scheint auch flexibler zu werden, seit neuestem geht auch „Mach das Licht an, statt schalte“ oder „Wie warm ist es im Wohnzimmer“ statt „Wie ist die Temperatur“
Es ist ein älterer DS218+. Allerdings mit aufgerüstetem RAM (10GB).
Das streamen von Filmen funktioniert einwandfrei. Deswegen denke ich hat das NAS genügend Power.
Ich habe aber auch schon überlegt HA auf einen Raspberry PI auszulagern. Würde das was bringen?
Aber welche Rolle spielt noch die Plattform, wenn der Sprachassistent auf Cloud eingestellt ist?
Hatte ich auch mal.  Jetzt werkelt hier nur noch eine DS720+ vor sich rum.
Nein das ist leider ein Trugschluss, denn für das streamen werden üblicherweise einfach nur die Daten per LAN und SMB/NFS/DLNA an den Client übertragen. Um das interpretieren und ggf. auch noch codieren/konvertieren der Daten, ist dann der Client zuständig. Es sei denn Du würdest dies (noch) die DS218+ machen lassen, was sie als + Modell, mit der darin verbauten Intel Celeron J3355, das ja noch könnte.
Nein für eine lokale Sprachsteuerung wäre der m.M.n. auch zu schwach. Ein Raspi 4 auf jeden Fall.
Ich will jetzt auch nicht behaupten das Deine DS218+ das nicht vielleicht doch schafft und das das die Ursache für Deine Probleme ist. Das HA Voice Teil und die Sprachsteuerung von HA, steht halt - verglichen mit Alexa und Google Home - noch ziemlich am Anfang und Du darfst die auf keinen Fall mit der Qualität von Google Home über Deinen Hub Max vergleichen. Daran ändert sich auch nicht viel wenn Du da jetzt eine leistungsstärkere Kiste als Deine DS218+ nutzen würdest.
Hast und nutzt Du denn bereits Nabu Casa? Falls ja würde ich an Deiner Stelle darüber eher Google Home + Deinen Nest Hub mit HA für die Sprachsteuerung nutzen. Das mache ich hier schon seit ein paar Jahren und ich bin ziemlich zufrieden damit. Für mich ergibt sich somit und b.a.W. gar keine Notwendigkeit da mit irgendwelchen HA-eigenen Lösungen irgendwelche “Experimente” zu machen. Eben weil ich u.a. auch weiß das die Ergebnisse davon und damit dann schlechter wären als sie es jetzt mit der Kombination von HA + Nabu Casa + Google Home + Nest Hubs sind.
VG Jim
Danke @Jim_OS für die vielen Erklärungen.
Den Voice PE hatte ich angeschafft, weil Google meine Freundin sehr selten verstanden hat. 
Für mich funktioniert die Kombi mit HA und Nest Hub gut. Nun wollte ich dem Voice PE eine Chance geben. Da dachte ich, dass ich mehr Interaktions-Möglichkeiten habe.
NabuCasa (HomeAssistant Cloud) ist für den Sprachassistenten aktiviert.
Mit GoogleCloud habe ich es noch gar nicht probiert. Das werde ich mal angehen.
Zudem hat mir Gemini empfohlen, mein NAS mit einer externen SSD auszustatten und dort HA hin auszulagern.
Gut, ist das ganze ein Hobby. Sonst würde man doch nie diesen Aufwand betreiben 
Ich fange mal hinten an: Ja eine SSD für den VMM und die VM(s) ist auf jeden Fall eine gute Idee.
Was dann Google Home und HA + Nabu Casa betrifft sollte ich vielleicht noch ergänzen das ich schon immer das per HA Scripte mit dann sehr kurzen Befehlen mache. Ein Beispiel. Wenn ich z.B. die Außentemperatur per Sprachausgabe erfahren will sieht das HA Script dann so aus.
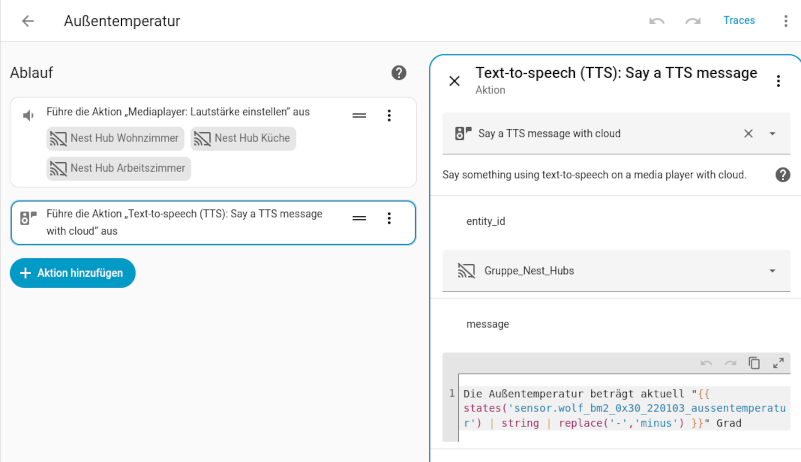
Die Außentemperatur liefert mir mein Außenthermometer meiner Wolf Heizungsanlage, welche bei HA eingebunden ist. Bei Google Home ist dann als Sprachbefehl für das starten des HA Scripts einfach hinterlegt/definiert: Außentemperatur
Die Spracheingabe für HA über einen Nest Hub lautet dann einfach kurz und knackig: Hey Google Außentemperatur und nicht so etwas wie z.B. Hey Google wie ist gerade die Außentemperatur. Oder Hey Google wie ist gerade die Temperatur draußen.
Somit vermeide ich das Google erst noch groß “nachdenken” und interpretieren könnte oder müsste was ich jetzt genau meine. Denn das ist eben eine potentielle Problem- und Fehlerquelle. So funktioniert das bei mir halt seit Jahren ziemlich gut. Ob das dann auch bei anderen Usern der Fall ist und/oder wie die dabei vorgehen, steht auf einem anderen Blatt.
VG Jim
Also das gilt zwar immer noch, aber nur für mich als Benutzer. Hier im Büro also okay, ich kann mir das merken, was genau gesagt werden muss, um ein bestimmtes Ziel zu erreichen. Aber sobald die Familie auf so ein Gerät zugreifen soll, wird’s schwierig, dann gilt wieder:
Deshalb habe ich es fürs WoZi (da steht zum Testen eine AtomS3R-Atomic Echo Base-Kombi) nun mal ganz anders gelöst.
Der STT-Part läuft über den Azure Speech Service von Microsoft, via Wyoming Microsoft STT - Addon.
Als Konversationsagent dient der Conversation-Teil von der Anthropic-Integration (mit claude-haiku-4.5).
Das steht natürlich im krassen Gegensatz zu meinem ursprünglichen Ansatz, alles lokal machen zu wollen. Aber ich wollte auch so etwas mal ausprobieren, und es funktioniert echt erstaunlich gut.
Wir können mittels natürlicher Sprache mit unserem HA kommunizieren. Der kleine Würfel (Atom-Echo-Kombi) versteht uns, egal wie gerade formuliert wird.
Die Sprachausgabe über das Mini-Teil kann man natürlich knicken, sowas geht fürs WoZi gar nicht. Deshalb habe ich das (den tts-output) umgeleitet auf einen vorhandenen Echo mithilfe der Mic-to-Mediaplayer Integration. Klappt auch prima. Eine Verzögerung der Antwort um eine knappe Sekunde muss man aber hinnehmen.
Das Ganze steht erst seit gestern; ich bin erst mal froh, dass alles läuft und in etwa auch den Erwartungen entspricht.
Ein paar Feinabstimmungen kann man sicher noch machen, aber letztendlich bleibt so etwas natürlich ein Test-Projekt, welches Amazons Echos und die Google-Geräte nicht ersetzen wird, das war aber natürlich auch nicht der Anspruch.
Das gleiche Setup habe ich übrigens jetzt mal zum Testen auf dem Voice PE im Büro für eines der beiden aktiven Aktivierungswörter, das klappt genauso gut.
Update: Ich habe zwischenzeitlich weiter intensiv getestet und rumprobiert 
Erkenntnisse bisher:
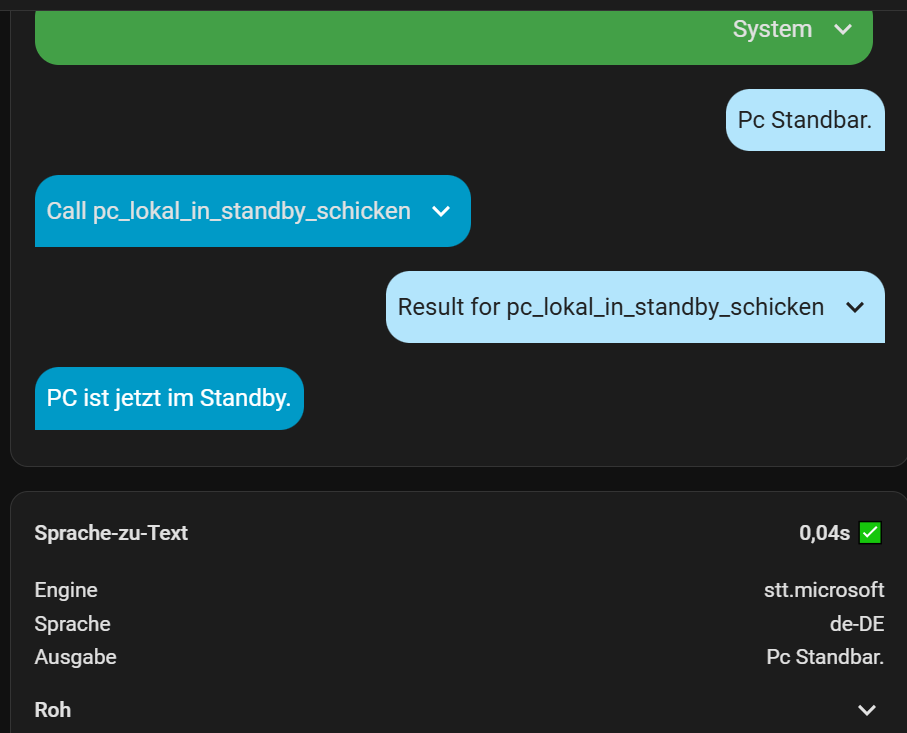
Microsoft Azure für STT erweist sich als echter Glücksgriff, ich nutze es jetzt immer, egal welcher Konfigurationsassistent genutzt wird. Nur äußerst selten mal wird unsere Sprache in falschen Text transkribiert. Dafür hier mal ein Beispiel (der Konv.-Agent hats trotzdem richtig erkannt!):
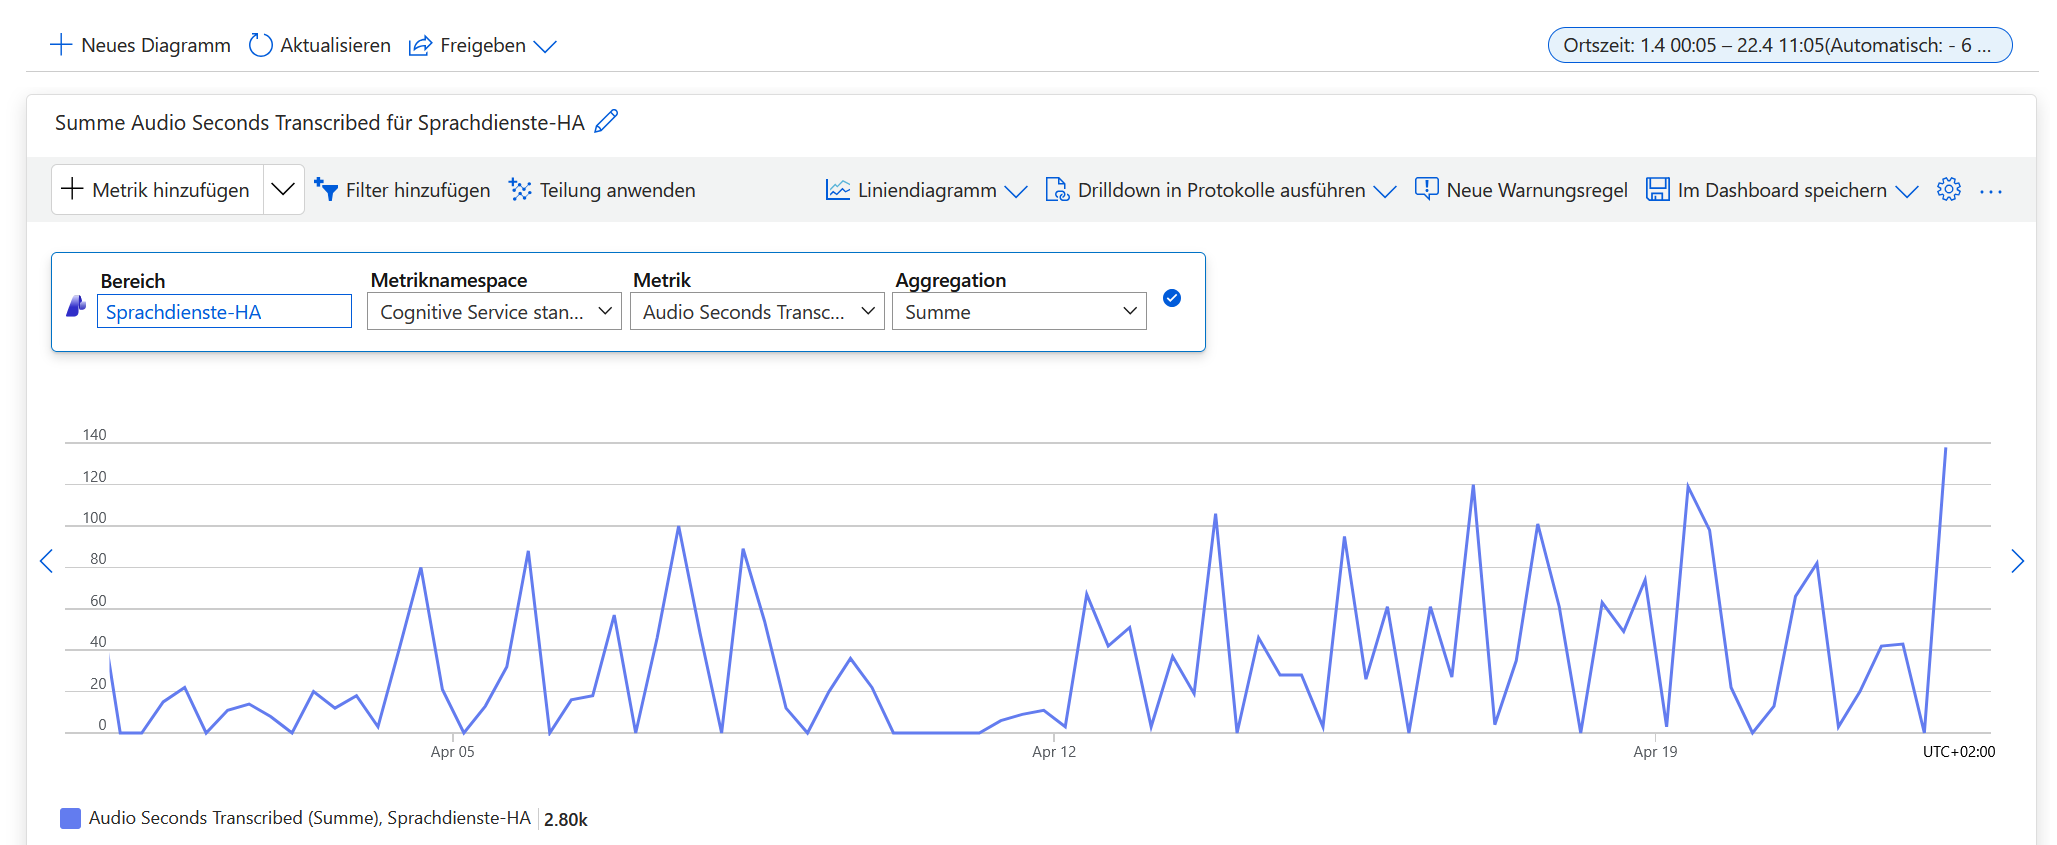
Und kostet nichts, man muss sich wohl schon sehr anstrengen, um die monatliche Freigrenze zu überschreiten. Sehr gut nachvollziehbar ist die Nutzung via Metriken:
Wird nach meinen Infos übrigens auch von der NABU-CASA-CLOUD genutzt, sowohl für STT als auch für TTS. Ich nutze für TTS lediglich Piper, es funktioniert für mich prima, warum sollte ich was ändern.
Zu den Konfigurationsassistenten:
Anthropic mit haiku-4.5 ist prima, aber zu teuer (im Vergleich zu dem, was ich später noch entdeckt habe). Ich habe versucht, die Anzahl der Token durch verschiedene Einstellungen zu drücken, das gelingt auch, bleibt aber trotzdem recht teuer. Aber sehr gut!
Google’s Gemini hat hier doch öfter mal gestreikt, ab und zu einfach “unavailable”.
Also weiter gesucht; um OpenRouter kommt man wohl nicht herum, wenn man Modelle für HA mal testen möchte. Ich habe jedenfalls schon so einige ausprobiert. Momentan bin ich bei DeepSeek V3.1 Terminus und OpenAI: gpt-oss-20b gelandet. Nutze sie im Wechsel, auf der Suche nach Unterschieden… 
Beide funktionieren sehr gut, halten sich an den Prompt, sind recht günstig und schnell. Wobei gpt-oss bei beidem leicht vorne liegt, mal schauen nach einer längeren Testzeit, wie es dann aussieht.
OpenRouter nimmt 5,5% als Marge, das ist okay für mich. Jede Anfrage erscheint fast zeitgleich dort in den Logs, so kann man mal schnell nachschauen, wie viele Token verbraucht wurden:

Insgesamt bin ich jetzt echt super zufrieden; was mein smartes Zuhause betrifft, ist der VoicePE den Alexa-Geräten zumindest in manchen Dingen schon überlegen. Ein Beispiel:
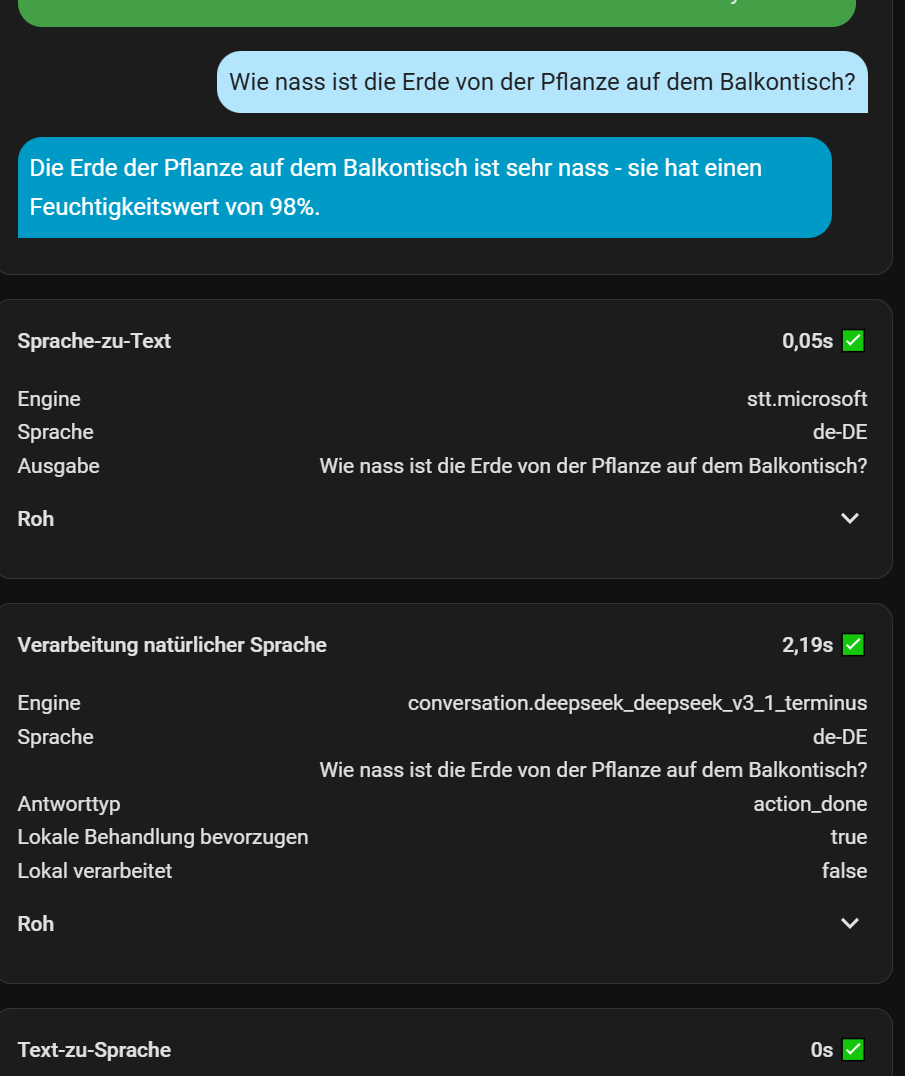
Also eine Frage nach einem Sensorwert mal absichtlich kompliziert formuliert, so als hätte ich den Namen des Sensors vergessen. Zur Verfügung stehen dem System nur
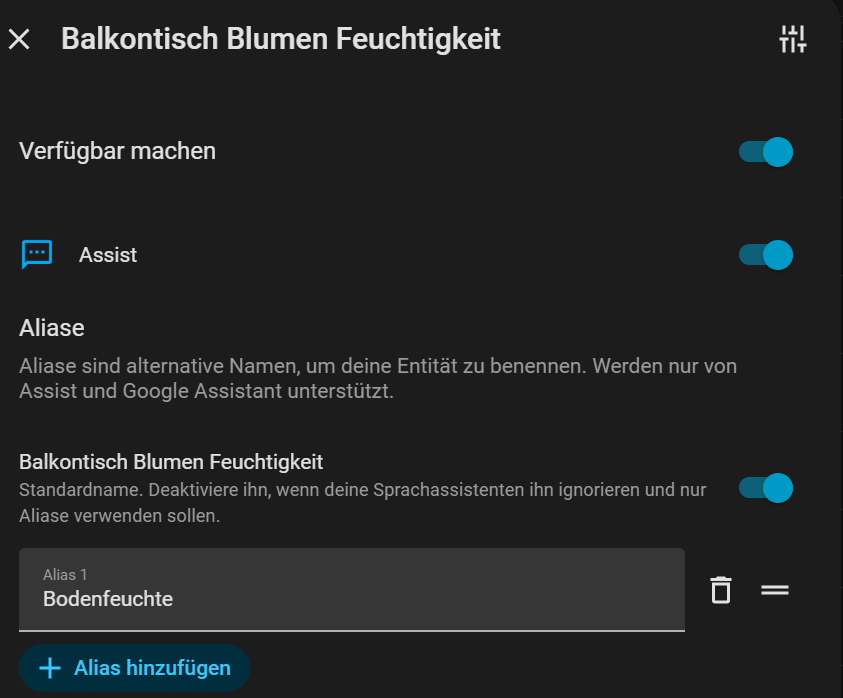
Trotzdem erhalte ich eine korrekte Antwort, klasse! Wäre mit Alexa so nicht möglich, die braucht exakte Formulierungen, in HA hätte ich erst mal ein Script erstellen müssen und dann in der Alexa-App eine Routine. Den VoicePE kann ich einfach fragen…
Oder die Einkaufsliste, ich nutze Bring: “Alexa, öffne Bring und füge Räucherforelle hinzu”. Klappt nicht, manche Wörter werden vom Skill einfach nicht akzeptiert. Muss dann eine Ersatzformulierung her. Mal ganz abgesehen von dem zunächst notwendigen umständlichen Öffnen des Skills…
Dem Assist sage ich einfach, was ich möchte, und es wird gemacht:
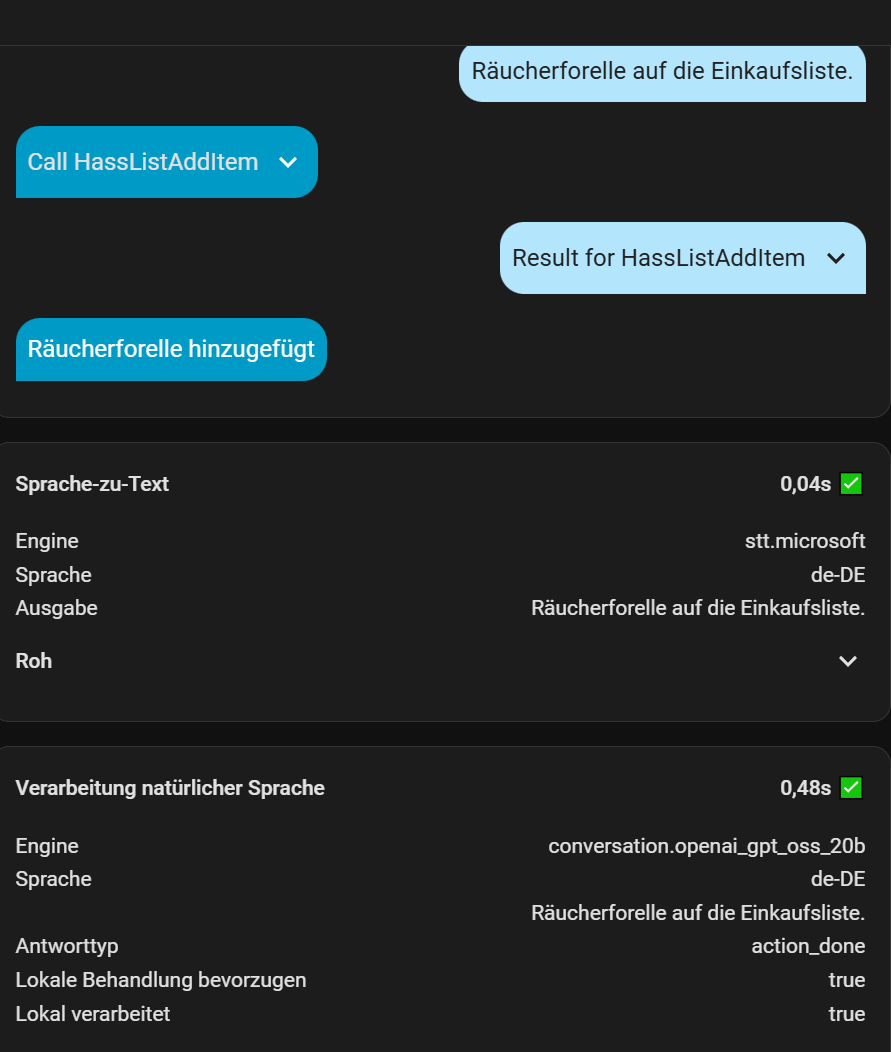
Erscheint umgehend in Bring (Bring ist im Prompt als alleinige Einkaufsliste festgelegt). Letzteres war gleichzeitig mal ein Beispiel für lokale Verarbeitung. Das wird automatisch immer bevorzugt, soweit möglich, und kostet dann auch keine Token.
Aber manchmal, zum Glück selten, geht auch alles schief : Ich: “OK Nabu, spiele Baranquilla Estereo auf der Soundbar”. Heraus kam
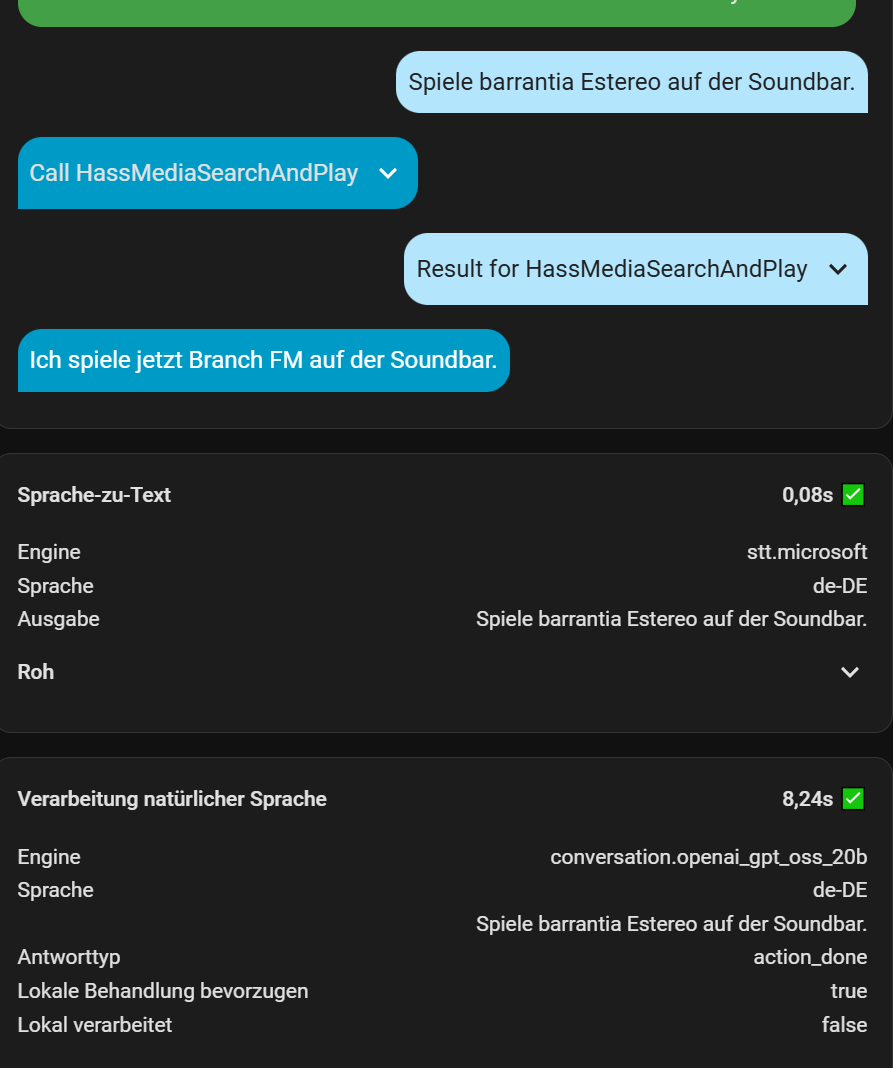
Alles in allem macht es so jetzt richtig Spaß mit VoicePE &Co. 
Und da ich sowas in unserer Küche schon jetzt richtig vermisse, wird dafür demnächst auch noch ein Gerät bestellt.