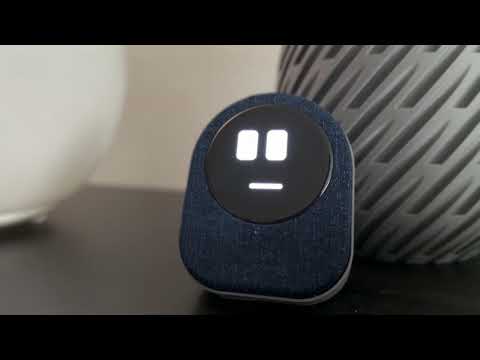
Ich habe nach ersten Versuchen mit Home Assistant Assist den Wunsch gehabt, einen Sprachassistenten mit Display zu haben. Um dieses Ziel zu erreichen, habe ich ein kleines Projekt mit Claude Code gestartet.
Daraus ist eine eigene Firmware für das Waveshare ESP32-S3-Touch-AMOLED-1.75 entstanden, um diesen als Voice Satellite mit Display zu nutzen.
Alles, was auf dem Screen passiert, wird über HA Entities gesteuert. Keine App, kein Cloud-Dashboard, keine Extra-Konfigurationsebene.
Konkret gibt es:
Atmendes Mikrofon beim Zuhören, Punktwelle bei der Verarbeitung, Equalizer bei der Antwort als visuelles Feedback
Drei Standby Seiten: Uhr mit Datum, zeigerloses Zifferblatt und das Highlight: ein animiertes Gesicht mit wandernden Augen
Timer als Ring um den Bildschirmrand, der sichtbar runterzählt
Single und Double Tap als eigene Events, Abbruch der Aufnahme durch Antippen
Möglichkeit der Einbindung in eigene Automationen
Entities für Orientation, Standby Brightness, Microphone Muted, Wake Word Engine, Recognized Text und Response
Für den Anfang liegen sechs Blueprints bei, unter anderem Hinweis bei Ereignis, Ansage via assist_satellite.announce, Wetter auf Nachfrage mit Icon, Musiksteuerung über Music Assistant und eine LLM-gestützte offene Wetterfrage. Die Trigger-Formulierungen sind für deutschsprachige Pipelines ausgelegt.
Geflasht wird über den Browser via ESP Web Tools direkt per USB. Updates kommen danach ganz normal über Home Assistant
Bin gespannt, ob und wie ihr das einsetzt, gerade wenn ihr schon mehrere Satellites im Einsatz habt und wisst, worauf es bei sowas ankommt. Ich freue mich auf Anmerkungen.
Ich nutze den Assist viel und habe ein paar Satelliten. Dein Projekt sieht cool aus. Meine Frau findest es aber leider gruselig vielleicht hast du ein Video, wo sich das Gesicht ganz niedlich bewegt
Aber wenn ich es richtig sehe, hast du nirgends geteilt, wie du das ganze um das Board herum gebastelt hast. Also ist das ein 3D Druck oder wie?
Hast du einen HA Preview Edition? Wenn ja, wie würdest du die Erkennung von Sprache im Vergleich beurteilen?
Vielen Dank für deinen Kommentar. Dieser hat mich sehr amüsiert. Ich verstehe die Bedenken deiner Frau durchaus! Ich habe mich auch noch nicht zu 100% dran gewöhnt Die meiste Zeit des Tages ist er schwarz und aktiviert sich erst wenn er etwas erkannt hat. Hier ist ein kleines Video ohne Ton. Am Ende seht Ihr auch die Erkennung (blau), das Nachdenken (gelb) und anschließend die Mundbewegung bei der Audioausgabe. Das Video ist ungelistet auf YouTube verfügbar. Vielleicht binde ich es noch einmal auf GitHub ein.
Genau, das Gehäuse habe ich noch nicht geteilt. Es ist ein 3D Druck, wo ich die Vorderseite mit Jeansstoff bespannt habe, da mir die Optik sehr gut gefällt. Ich plane auf jeden Fall noch ein Modell zu veröffentlichen. Es gibt diverse Druckmodelle auf Makerworld, die mir allerdings nicht zugesagt haben.
Ich habe keine PE, sondern nur einen M5Stack Atom Voice. Ich konnte keine Unterschiede entdecken. Ich habe in der Firmware das Dual Mikrofon aktiviert und die Voice Suppression auf 0 gesetzt, da ein höherer Wert zu einer höheren Latenz zwischen Befehl und Verarbeitung führt. Das sind die gleichen Parameter wie bei der PE. Wenn ich etwas sage, wird es auf jeden Fall immer erkannt. Leider gibt es dennoch falsch positive Auslösungen. Allerdings passiert das bei meinem HomePod auch. Ich denke, dass man es ausprobieren muss.
Morgen
Sehr schön, gefällt mir gut. Könnte mir gut vorstellen das in den kommenden Herbstwocehn mal nachzubauen. Wenn ich kann gerne auch was zum Projekt beitragen -bin mit uCs groß geworden.
Was mich bei diesen alternativen Spracheingabeprojekten aber immer störte ist die Erkennungsgenauigkeit. Sowohl akustisch als auch logisch.
Für mich und mein Frau … sind hier die Echos immer noch die Referenz-
-kommt es da ungefähr hin ??
gruß bb
Guten Morgen,
zur akustischen Erkennungsgenauigkeit: Ich habe den Vergleich mit einem HomePod mini und ich sehe dort kleinere Abschnitte. HomePod (und auch Echo) arbeiten schließlich mit viel mehr Richtmikrofonen. Das ist bei dem kompakten Design aus einem Display mit integrierter Platine dann halt der Punkt, wo man Abstriche machen muss. Für mich funktioniert die Erkennung auch aus einem Nebenraum. Am Ende ist es wahrscheinlich individuell. Wenn ich mit mit dem Satellite im selben Raum befinde, funktioniert die Erkennung wunderbar.
Zur logischen Erkennungsgenauigkeit: Wenn man in HA ein LLM als Pipeline nutzt, ist es hervorragend. Wenn man nur die lokale Pipeline von HA nutzt, muss man exakt die richtigen Begriffe treffen. Dieser Punkt hängt also stark vom eigenen Setup bzw. Bedenken hinsichtlich der Nutzung eines LLM zusammen.
Viele Grüße!
Danke für deine Eeinschätzung.
Spracherkennung mit einer LLM verheiraten fände ich schon sehr spannend. Habe ein
Ollama auf UNRAID laufen. Mal schaun ob ichs schaffe das einzurichten.
gruß
bb
Also meine kurze Recherche hat ergeben, dass man mit der Ollama Integration direkt einen Conversation Agent einrichten kann, den man anschließend an Assist übergibt. Das kannst du auch schon ohne mein Gerät nur in der App ausprobieren. So habe ich auch begonnen. Dann kommunizierst du erst einmal nur über die App.
Wenn du das mit Lumi verbunden hast, berichte gerne mal von deinen Erfahrungen. Ich finde das sehr interessant und wäre für mich auch der logische nächste Schritt.
Ich habe gerade gesehen, dass ich gestern gar nicht richtig auf deinen Beitrag geantwortet habe. Du findest meine Antwort als ganz normalen Beitrag im Feed
Nunja, Du wirst mit einem lokalen Sprachmodell nie an die Server von Amazon oder Apple herankommen.
Im Prinzip könnte man lokal ja auch das Teil von Nabu Casa einsetzen, welches aber kein so schönes Gesicht zeigt ….
Das ist (leider) auch meine Erfahrung. Wenn es rein um das Steuern des Smarthomes geht, dann reicht für mich ein lokales Modell. Allerdings muss man sich an gewisse Latenzen gewöhnen, vor allem wenn man eine Sprachausgabe möchte.
Wenn es aber z.B. darum geht, dass der lokale Assistent Alexa ersetzt, dann habe ich auf Gemini zurück gegriffen. Allerdings gehen dann meine Daten auch wieder nach draußen.
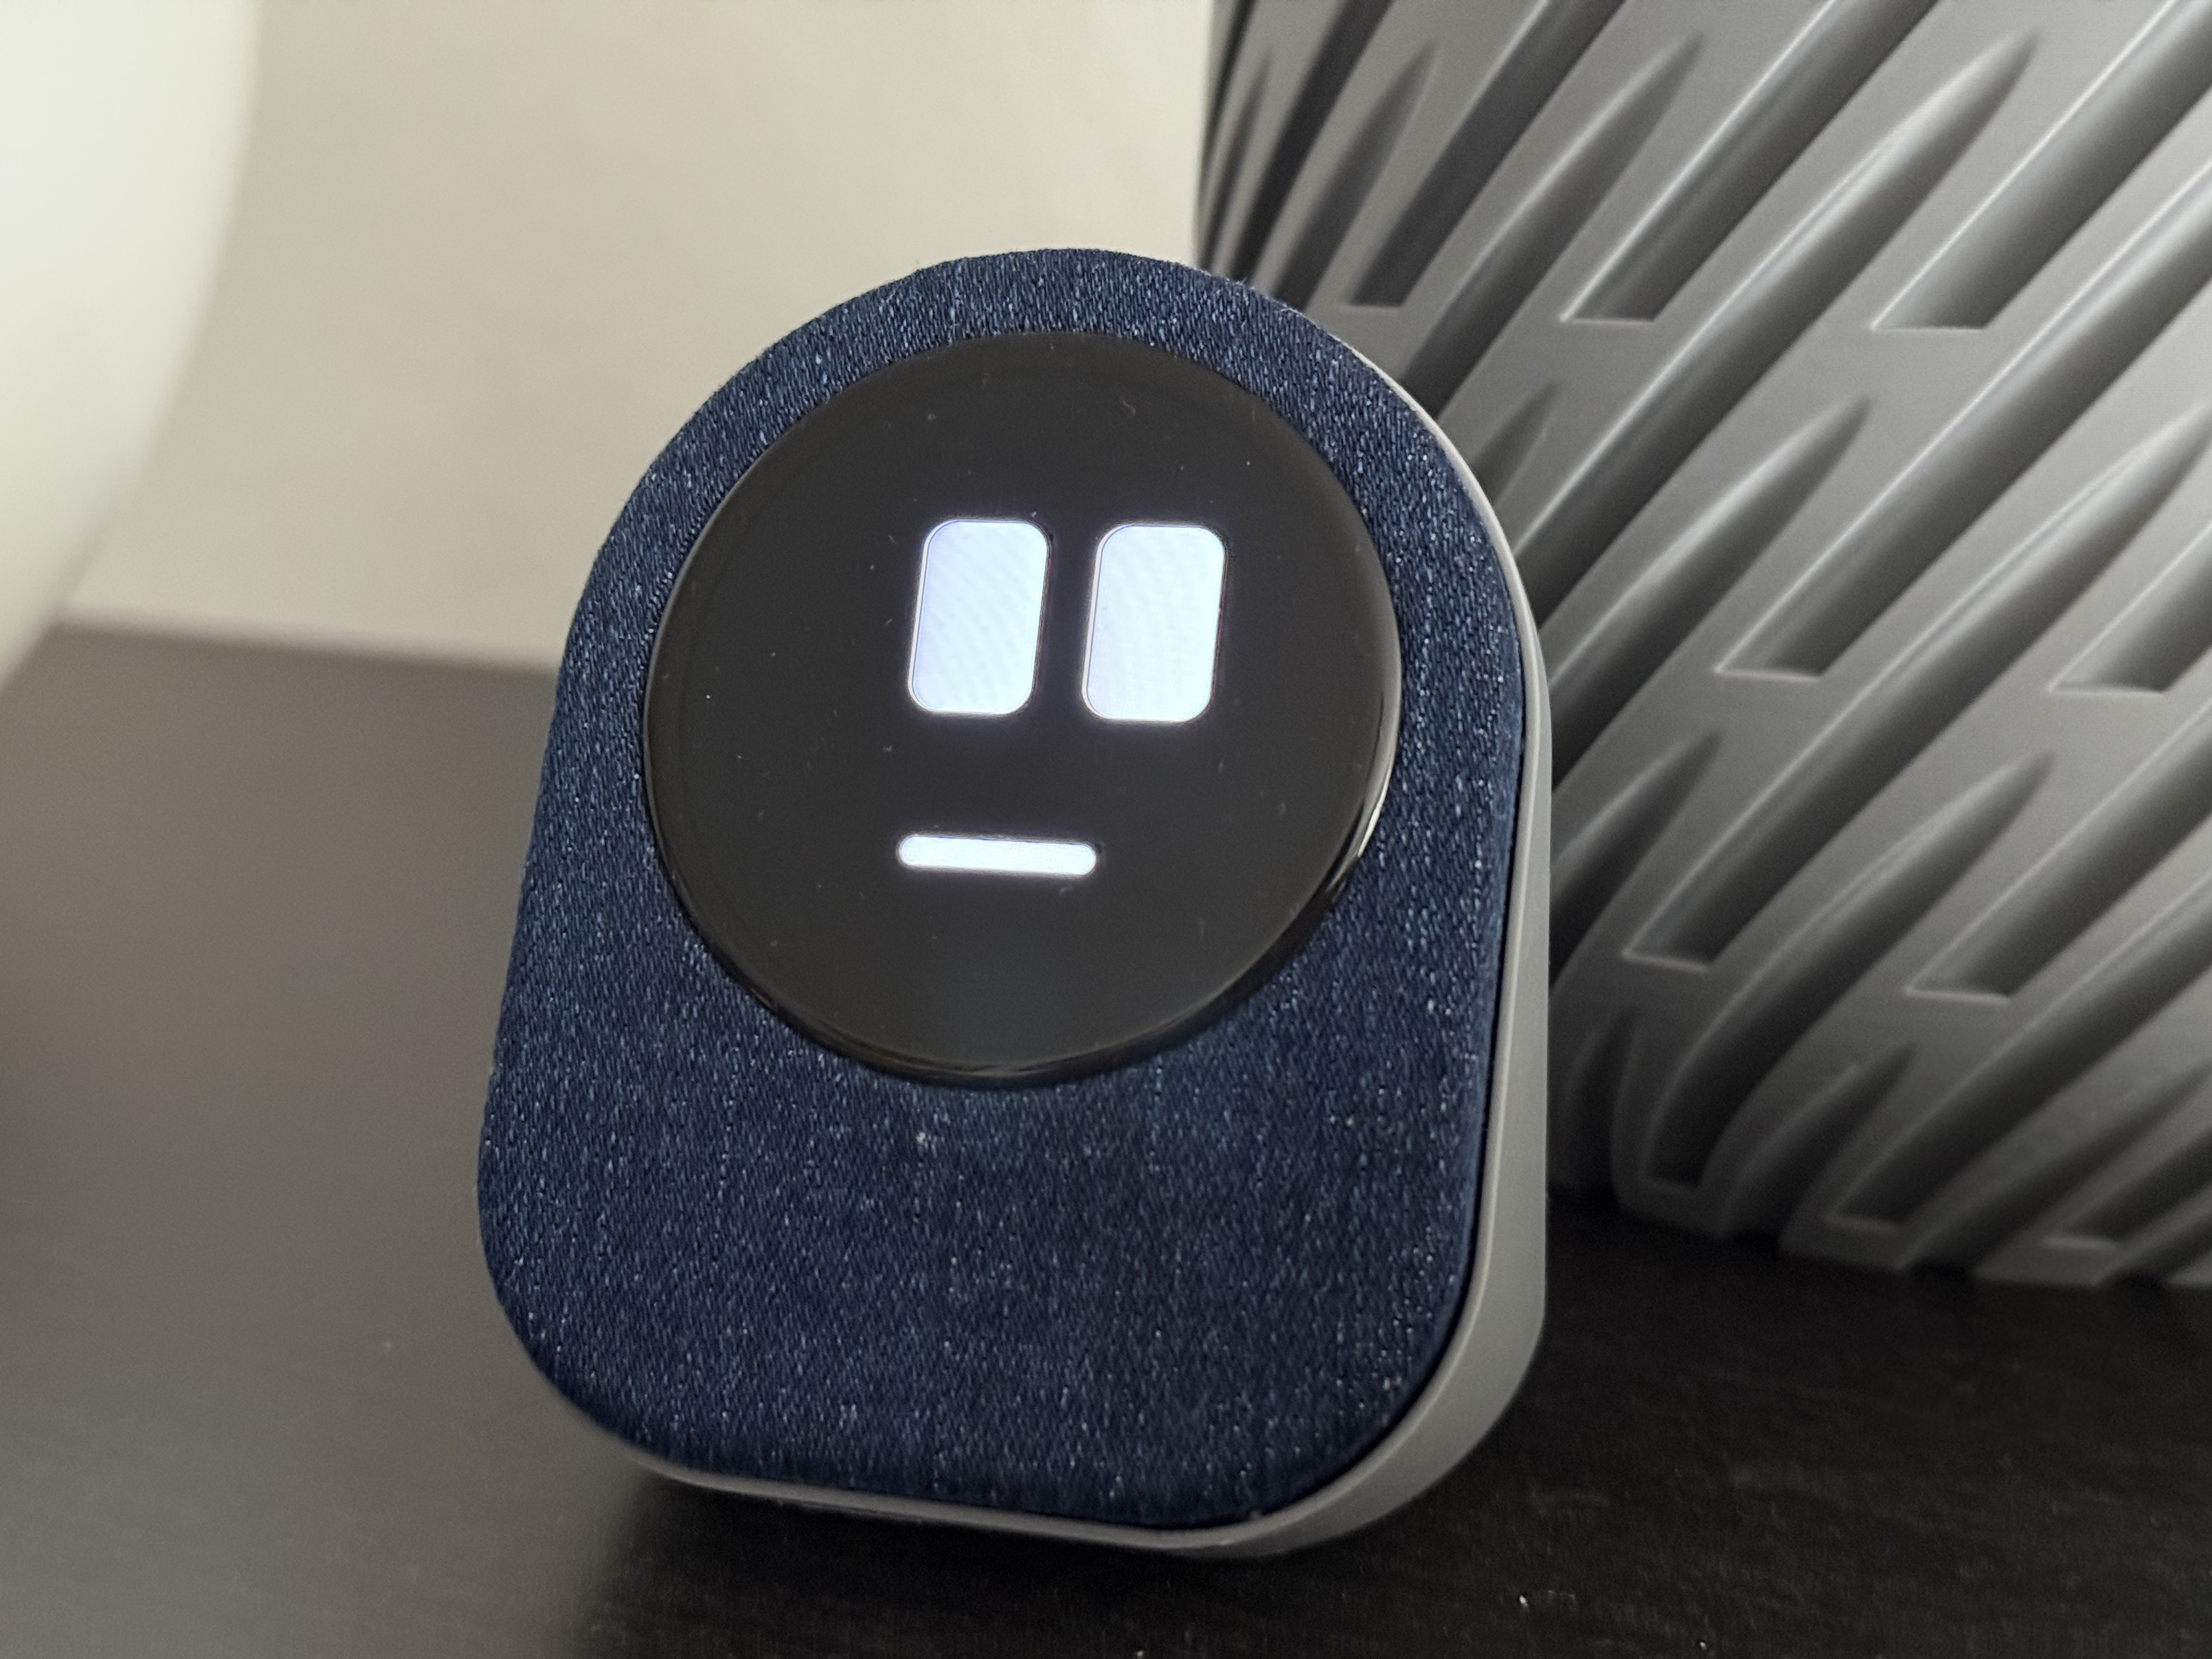
 vielleicht hast du ein Video, wo sich das Gesicht ganz niedlich bewegt

 Die meiste Zeit des Tages ist er schwarz und aktiviert sich erst wenn er etwas erkannt hat. Hier ist ein kleines Video ohne Ton. Am Ende seht Ihr auch die Erkennung (blau), das Nachdenken (gelb) und anschließend die Mundbewegung bei der Audioausgabe. Das Video ist ungelistet auf YouTube verfügbar. Vielleicht binde ich es noch einmal auf GitHub ein.