Ich befinde mich in der Planungsphase eines AI-Projekts und möchte nun die Machbarkeit verschiedener Komponenten prüfen. Ich teste derzeit (bzw. fang an) dieses Konzept zunächst mit meinem MacBook Pro M1 (32 GB RAM), bevor ich den Kauf eines dedizierten Systems vornehme.
Ziel des Projekts: Aufbau einer KI-gesteuerten Sprachschnittstelle für mein Heimautomationssystem (Home Assistant via Nabu Casa). Die KI soll Anfragen in natürlicher Sprache entgegennehmen, diese verarbeiten und die notwendigen Aktionen ausführen.
Technische Anforderungen:
Lokaler KI-Kern (LLM): Das LLM soll lokal auf einem dedizierten Gerät laufen und die Schnittstelle zur HA-API bilden.
Hardware-Option: Die eigentliche Intelligenz soll idealerweise auf einem Mac Mini M4 (16–24 GB RAM) gehostet werden.
Funktionalität: Die KI soll in der Lage sein, Sprachbefehle wie entgegen zu nehmen und die Autoren zu schalten aber es soll auch möglich sein per Terminal/Webinterface z.B. “Erstelle eine Automation: Wenn morgens zwischen 6 und 7 Uhr das Badlicht an ist, schalte die Kaffeemaschine ein” zu verstehen und umzusetzen. Darüber hinaus soll sie Wetterdaten oder Radio-Streams über das Internet abfragen können.
Erfassungsgerät: Ich suche außerdem nach einem kompatiblen Sprachausgabegerät (Speaker), dessen Klangqualität dem von HomePod entspricht.
Meine Frage an die Community:
Hat jemand ähnliche Erfahrungen gesammelt? Welches LLM ist für diese Aufgaben am sinnvollsten?
Okay, aktueller Stand: Ich habe LM Studio installiert – also die Software, nicht das eigentliche LLM. Das sollte man ja schnell wechseln können, falls Ollama dafür besser geeignet ist.
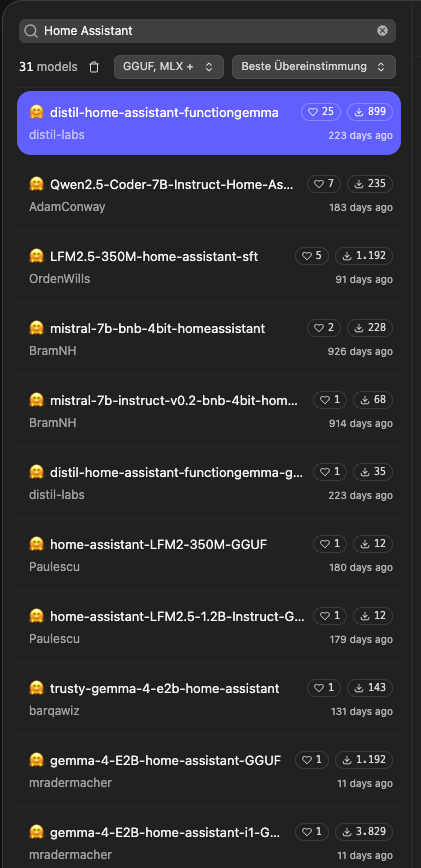
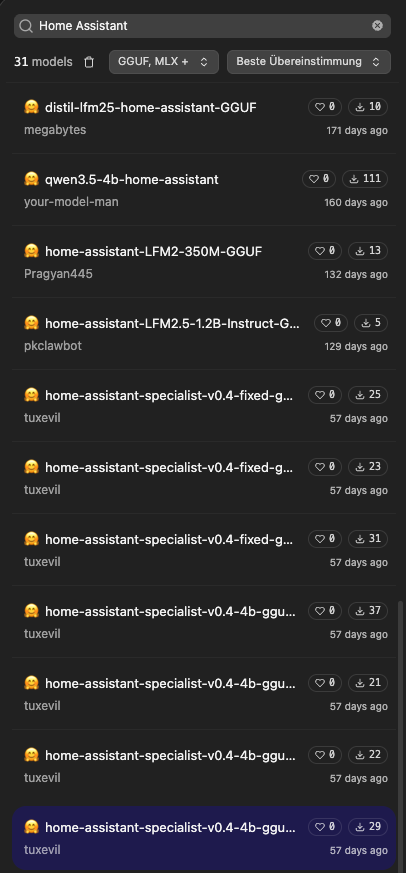
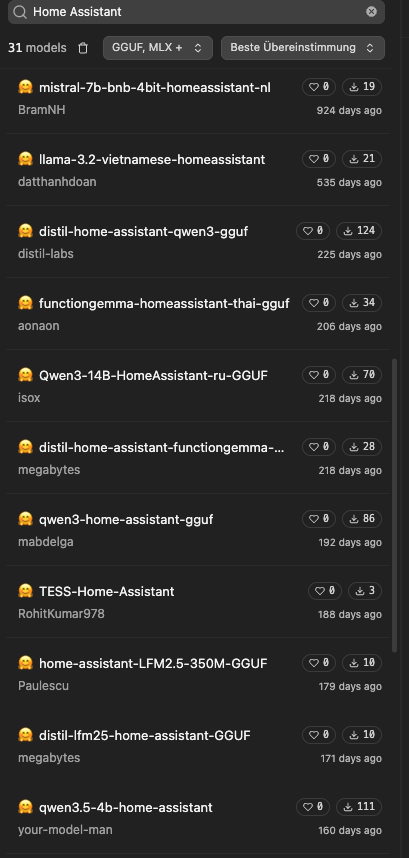
Was ich noch brauche, ist das passende LLM-Modell für mein Vorhaben. Ich hab gesehen, dass es da spezialisierte LLMs für Home Assistant gibt. Die Frage ist nur: Was taugen die wirklich bzw. was wäre ein gutes und schnelles LLM?
Auf dem Mac Mini die Apple-Silicon-Modelle über MLX nutzen (oder Ollama mit MLX-Backend). Die laufen nativ auf Unified Memory und brauchen keinen schweren Extra-Stack. Der Mac ist der KI-Kern, nicht Home Assistant.
Steuerung vom Mac aus nach HA, nicht umgekehrt. In der Testphase kurz absichern (erst prüfen, dann ausführen), im Zielbetrieb soll das LLM aber direkt schalten. Dafür SSH oder besser die HA-API nutzen – Hauptsache der Mac gibt die Befehle.
Alles lokal halten und Sprach-/Textanfragen direkt und unabhängig auf den Mac routen. Der Mac entscheidet und steuert.
Home Assistant nur als Ausführungsinstanz: Geräte, Zustände, Services. Die Intelligenz und Orchestrierung bleiben auf dem Mac.
kein Nabu-Casa.. wäre mir zu unsicher für so ein Vorhaben! Grundsätzlich würde ich es lokal halten. Alternativ mit VPN und Open WebUI …
Automationen erstellen, oder Fehler beheben ist noch einmal eine ganz andere Nummer… da brauchst du eine Lokale AI auf dem Mac die das kann.. aktuell kenne ich persönlich KEINE lokale KI die es zuverlässig kann. Selbst große externe LLM wie Claude machen z.T. grobe Fehler (je nach Auftrag) an dieser Stelle wäre ich eher sehr sehr vorsichtig. Nichts ist schlimmer als: Du bist nicht daheim und dein HA raucht ab..
Wenn es unbedingt Konfigurieren, Bauen, Debuggen sein soll, dann geht das aktuell nicht zuverlässig lokal. Extern wäre Grok-Bot eine Option (gerade im HA Kontext ist GROK 4.6 und 4.7 allen anderen LLM um Längen überlegen, Python ist es Claude.. alles andere ist Spielerei) , aber Du verlierst Daten- Souveränität und lässt eine externe LLM auf dein System los.. meine Meinung dazu habe ich schon mehr als einmal und eindrücklich dargelegt und rate davon entschieden ab.
Fazit (meine Meinung)
Steuern ja möglich mit klaren Guards und Rails und Mac macht es
Automationen erstellen, Debuggen, .. lokal aktuell nicht zuverlässig möglich
Grundsätzlich immer den Output prüfen. Die aktuell besten KI`s erreichen nur etwa 10-15% der Intelligenz eines Menschen und nur 5% der Intelligenz eines Menschen der genau weiß was er macht. - Sie sind nur Werkzeuge, die man “menschlich” überprüfen muss - > keine Intelligenz die Entscheidungen auf dem Level eines Menschen treffen kann..
Wichtig
Du musst vorher sehr genau definieren was soll / darf er und was nicht. Hier musst du dann die Rails und Guard setzen. Das kann HA nicht… daher muss das aktuell auf dem Mac stattfinden. Bitte nicht umgekehrt, das geht schief oder wird laggen…
Denkbarer Ansatz: Lokale KI Skills schreiben, die dann durch den MAC entgegen genommen werden. Beispiel: Licht an = SSH Befehl auf HA der einen Zustand eines Schalters setzt.. Trigger Sprach-LLM “Licht” & “an” … ect pp